IA y finanzas: de los tokens a la inversión. Cómo funciona un LLM, cuánto cuesta y dónde está el dinero
Qué es un token, cómo se entrena un LLM, cuánto cuesta cada respuesta y dónde está el dinero de la IA para un inversor. Guía con cifras de octubre de 2026.
Por el equipo de The Trader Journal59 min de lectura
En este artículo
- 01Qué es un token y por qué en español gastas más
- 02Cómo aprenden los LLM: los tres pilares (texto, imagen y audio)
- 03Cómo se entrena una IA. Fase 1: el pre-entrenamiento
- 04Fase 2: ajuste fino supervisado (SFT), aprender a responder como un asistente
- 05Fase 3: alineación (RLHF, DPO y razonamiento)
- 06En qué se diferencian OpenAI, Anthropic, Google, xAI, Meta y DeepSeek
- 07Cómo se calcula el coste de los tokens
- 08Usuarios gratuitos (freemium) y beneficio real
- 09Cómo fijan los límites de uso para que el usuario sea rentable
- 10Suscripción o API: qué es más rentable para un laboratorio
- 11Cómo afectan los nuevos modelos como Jev
- 12Por qué alucinan los modelos de IA
- 13Benchmarks: cómo se comparan los modelos de IA
- 14Coste e infraestructura energética de la IA
- 15Invertir en IA: dónde está el dinero
- 16Cómo analizar una empresa de IA y qué riesgos vigilar
- 17Radar del inversor: seguir los acuerdos para encontrar a los beneficiarios
- 18Si operas estas noticias, mídelo en tu diario
- 19Preguntas frecuentes sobre IA y finanzas
La inteligencia artificial generativa se cobra por tokens, se entrena con cantidades enormes de cómputo y mueve ya cientos de miles de millones de dólares de inversión al año. Para entender qué empresas cobran y cuáles pagan, primero hay que entender cómo funciona por dentro.
Esta guía va de lo técnico a lo financiero, en orden: qué es un token, cómo aprende y cómo se entrena un modelo de lenguaje, cuánto cuesta cada respuesta, por qué los usuarios gratuitos importan tanto, qué preguntas conviene vigilar (límites de uso, modelos nuevos, alucinaciones, benchmarks y energía) y, al final, dónde se concentra hoy el dinero de la IA y cómo analizar a las empresas de cada eslabón. Las cifras están actualizadas a octubre de 2026; cuando leas «M$», son millones de dólares.
Qué es un token y por qué en español gastas más
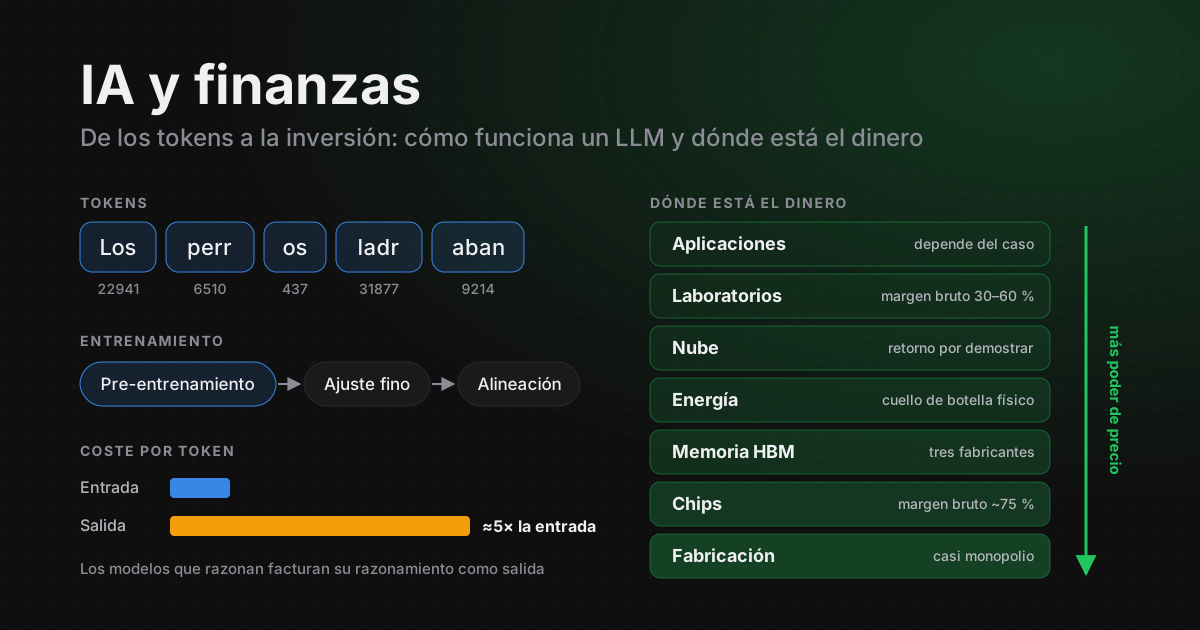
Un token es la unidad más pequeña de un fragmento de texto (una palabra, una parte de ella o un signo de puntuación) que los modelos de lenguaje grande, los LLM (large language models), usan como unidad básica para leer y escribir. ChatGPT, Claude o Gemini funcionan con LLM.
Cómo funciona un token
- La inteligencia artificial no lee letras sueltas ni palabras enteras de forma directa.
- Divide el texto en piezas más pequeñas llamadas tokens.
- Cada token recibe un número único (su identificador o ID) para que el sistema pueda procesarlo: para el modelo, una frase es una lista de números.
- Una regla general es que 1 token equivale a unos 4 caracteres en inglés. Anthropic lo traduce a palabras: unos 4 caracteres o 0,75 palabras en inglés (precios de Anthropic (se abre en una pestaña nueva)).
- En español, las palabras suelen requerir más tokens, en torno a 1,2–1,5 veces más que en inglés, porque los tokenizadores se entrenan sobre todo con texto en inglés y comprimen peor los demás idiomas. El fenómeno está documentado: un estudio presentado en NeurIPS 2023 lo describe como una desigualdad entre idiomas que introducen los tokenizadores (Petrov et al. (se abre en una pestaña nueva)).
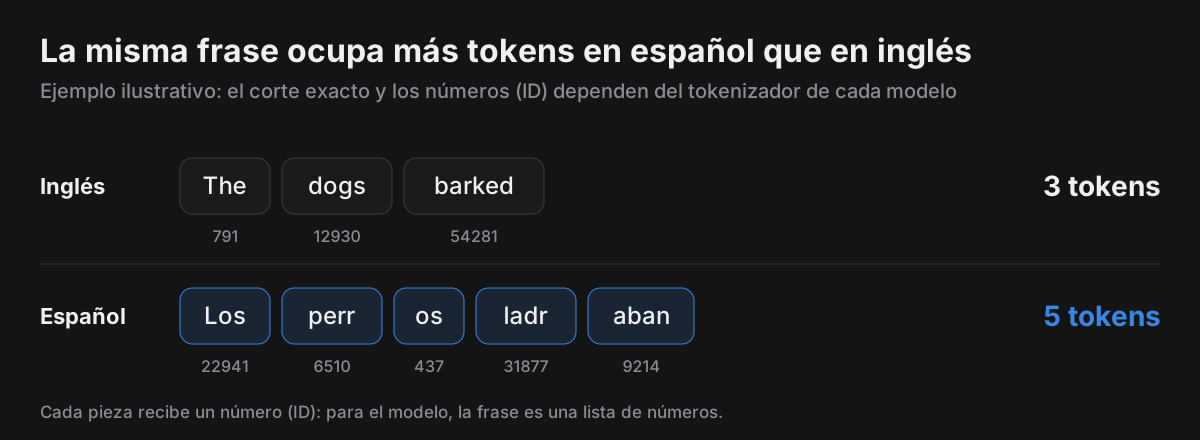
Puedes probarlo tú mismo con frases reales en el tokenizador de OpenAI (se abre en una pestaña nueva): pega una frase en inglés y su traducción al español y compara el número de tokens. Por consiguiente, dependiendo del idioma que uses, el mismo mensaje ocupará más o menos tokens.
Cuántos tokens son 1.000 palabras (cálculo aproximado)
- 01En inglés, con 0,75 palabras por token: 1.000 / 0,75 ≈ 1.333 tokens.
- 02En español, con 1,2 veces más: 1.333 × 1,2 ≈ 1.600 tokens.
- 03En español, con 1,5 veces más: 1.333 × 1,5 ≈ 2.000 tokens.
El mismo texto traducido al español ocupa unos 1.600–2.000 tokens en lugar de unos 1.333: pagas más y llenas antes la memoria del modelo.
Esto es muy relevante porque en la IA el token es el mecanismo de coste: es el precio que tienen los sistemas y aquello de lo que se nutren sus ingresos, ya sea mediante llamadas a la API (la conexión que usan los programas para pedir respuestas al modelo) o mediante suscripciones. Y por eso hay topes de uso. Son necesarios por varios motivos:
- Suponen el coste de infraestructura para las empresas: capacidad de cómputo, energía, tiempo de procesamiento…
- Determinan el valor real de coste y beneficio por usuario, ya que no todos los clientes pagan por ello.
Cómo se crea el vocabulario y por qué los tokens no se comparan entre modelos
- Cómo se crea el vocabulario. Antes de entrenar el modelo se entrena un tokenizador (normalmente BPE, Byte Pair Encoding): empieza con bytes sueltos y fusiona las parejas más frecuentes hasta tener 100.000–200.000 piezas. Las combinaciones muy habituales en inglés acaban siendo una sola pieza; las de otros idiomas, a menudo, varias.
- Los tokens no son comparables entre modelos. Anthropic indica que sus modelos desde Claude 4.7 usan un tokenizador nuevo que genera aproximadamente un 30 % más de tokens para el mismo texto (precios de Anthropic (se abre en una pestaña nueva)). Para comparar proveedores hay que medir el coste por tarea, no el precio por token.
- Implicación práctica. Si construyes algo sobre una API en español, presupuesta un 20–50 % más de tokens que en los ejemplos en inglés.
Cómo aprenden los LLM: los tres pilares (texto, imagen y audio)
Antes de entrar en el entrenamiento conviene aclarar una peculiaridad. Los LLM aprenden a partir de distintos tipos de datos, pero todo converge en lo mismo: grandes cantidades de datos que el sistema ingiere para aprender a predecir. El modelo busca cuál sería el siguiente valor más probable a partir de lo que acaba de escribir, de entre un abanico de posibilidades.
Esos datos llegan, como resultado, en cuatro materiales fundamentales:
- Sistemas escritos. Es el pilar tradicional de los modelos de IA: le pasas texto y te devuelve piezas de texto, ordenadas según lo que es más probable que deba escribirse.
- Sistemas de imágenes. Se le entregan muchas imágenes y las trocea en pequeños parches de píxeles (cada parche se convierte en un token) para aprender a interpretar todos los matices: colores, ordenación, formas…
- Sistemas de audio. Se le entregan fragmentos de audio para «entrenar» ese oído y que sea capaz de entender qué se dice, cómo se dice y con qué entonación.
- El vídeo es un cuarto pilar en auge: secuencias de imágenes más audio, con un coste de cómputo mucho mayor.
Así pues, hay tres pilares fundamentales (más el vídeo, que los combina), todos ellos construidos sobre una base de muchísimos datos. Y todos acaban convertidos en lo mismo: tokens.
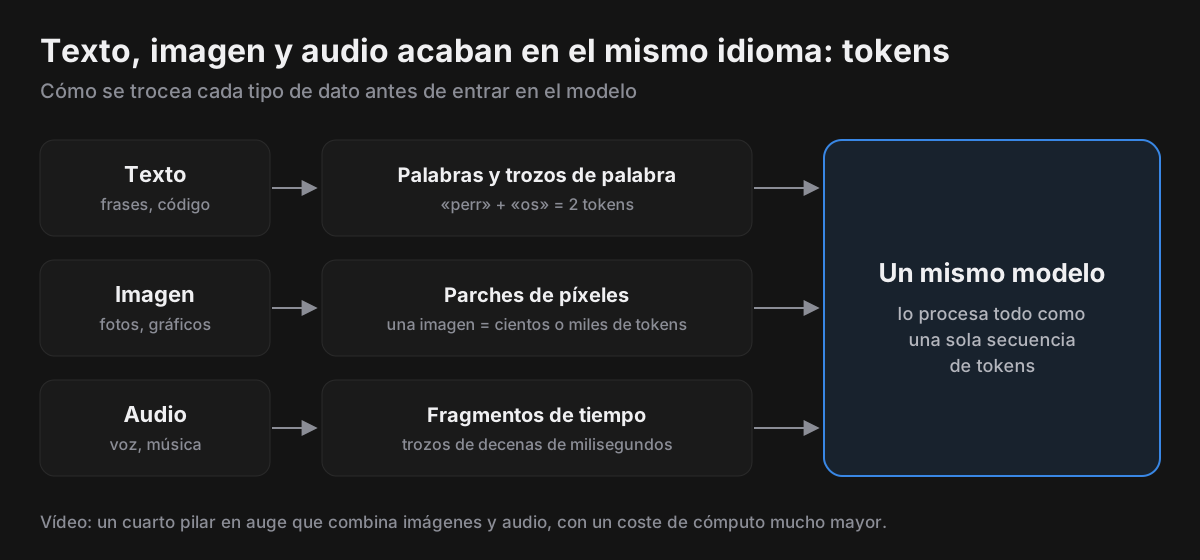
Modelos multimodales nativos. Los modelos frontera actuales procesan texto, imagen y audio en la misma red, en lugar de tener un sistema separado para cada pilar. «Multimodal» significa justo eso: que entiende varios tipos de datos a la vez.
Cómo se entrena una IA. Fase 1: el pre-entrenamiento
El entrenamiento de este tipo de sistemas es complejo, pero una vez se entiende es bastante fácil de asimilar. Consta de tres fases: pre-entrenamiento, ajuste fino supervisado y alineación. Cada una parte del modelo que deja la anterior.
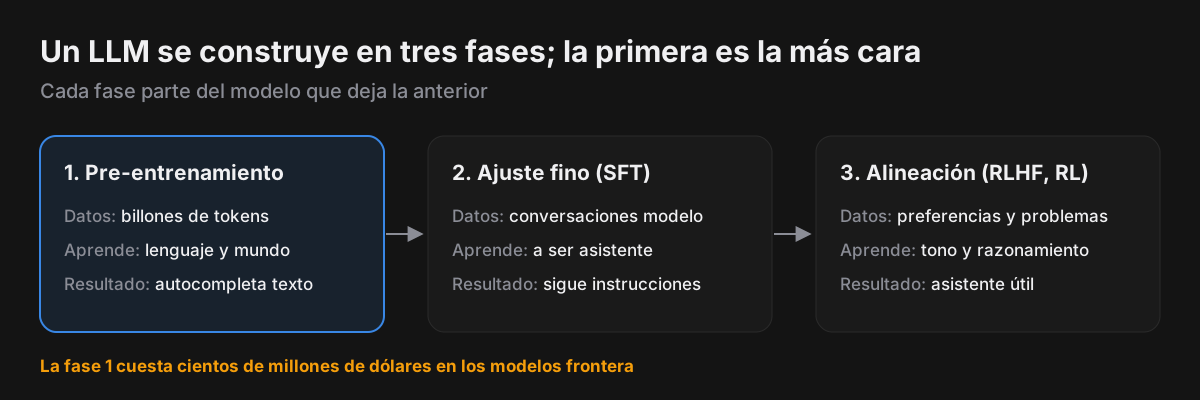
El pre-entrenamiento es la fase más costosa, tanto en tiempo como en recursos y capital para la empresa: hablamos de cientos de millones de dólares en los modelos más avanzados. En ella el modelo extrae información de billones de tokens procedentes de libros, webs, código, artículos…
Una vez se tienen todos los datos, el objetivo es muy sencillo: ser capaz de identificar, mediante millones de ejercicios de prueba y error, cuál es la siguiente palabra (token) que toca a continuación de un texto.
Este entrenamiento se basa en el descenso de gradiente: medir cuánto se equivoca el modelo y corregirlo un poco en la dirección que reduce ese error, millones de veces. Una pieza clave es la vectorización (embeddings): dar a cada palabra una serie de coordenadas para acabar encontrando las que más relación tienen entre sí.
A la vez se ajustan miles de millones de parámetros, los números internos del modelo: las capas de atención, que deciden qué palabras del contexto mirar, y las capas internas, donde se almacena gran parte del conocimiento. Cuando se dice que un modelo «tiene 400.000 millones de parámetros», se habla de 400.000 millones de esos números ajustables.
Un ejemplo: «El perro ladró en el ___»
Los modelos actuales predicen siempre la palabra siguiente a partir de lo que va antes. Al principio, cuando las coordenadas de todas las palabras son totalmente aleatorias, pasa esto:
- La IA mira las coordenadas aleatorias de «El», «perro», «ladró», «en», «el».
- Hace un cálculo geométrico a ciegas y adivina una palabra al azar: predice «camión».
- El sistema compara «camión» con la palabra real que venía a continuación: «jardín».
- El ajuste: el algoritmo calcula el error (la distancia entre lo que dijo y la verdad) y hace un leve movimiento en las coordenadas y en los parámetros: acerca «jardín» al contexto de «perro» y «ladró», y aleja «camión» de ese contexto.
Con tantas repeticiones, lo que se acaba haciendo es agrupar muchas palabras dentro de un vecindario geométrico. Por ejemplo, «el perro come» o «el gato come» son frases factibles, pero «el camión come» no tiene sentido; así que, la próxima vez, las coordenadas relacionadas con comer situarán a perro y gato más cerca, porque es más probable encontrar esa coincidencia. Piensa en un mapa de una ciudad en el que las palabras que se usan juntas acaban viviendo en el mismo barrio.
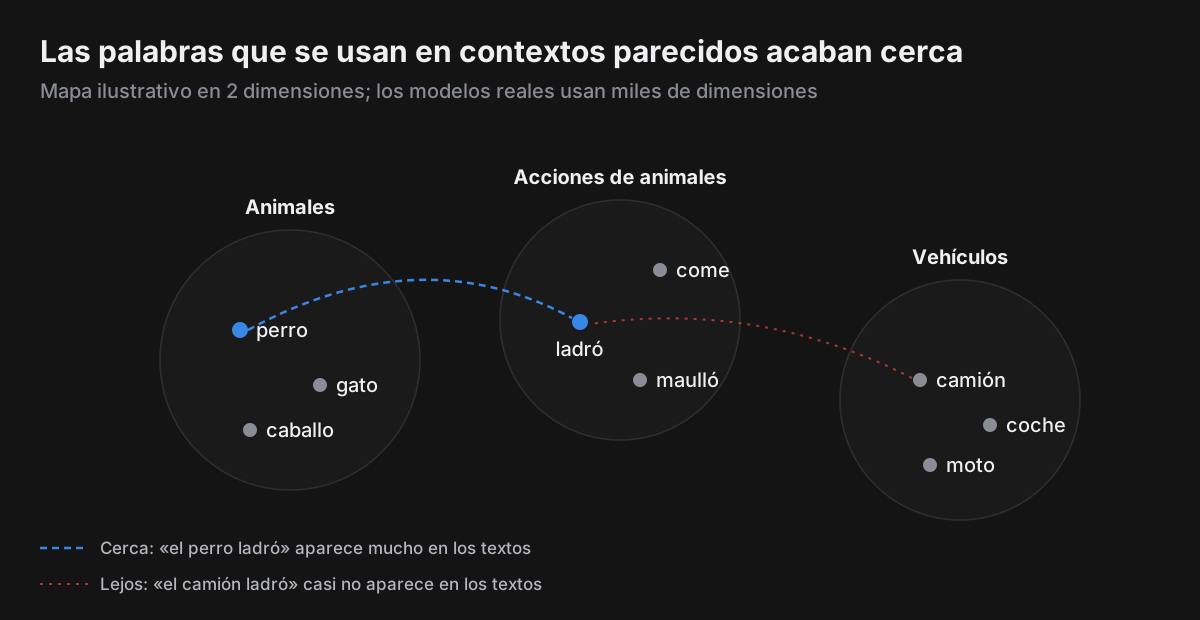
Por consiguiente, las coordenadas de una palabra son el resultado de todas las frases en las que ha aparecido. Si dos palabras tienen coordenadas muy parecidas, no es porque la IA sepa lo que son, sino porque se usan exactamente en los mismos contextos lingüísticos. Si quieres verlo con tus propios ojos, aquí tienes una forma sencilla de explorarlo: projector.tensorflow.org (se abre en una pestaña nueva).
Cuánto cuesta el pre-entrenamiento
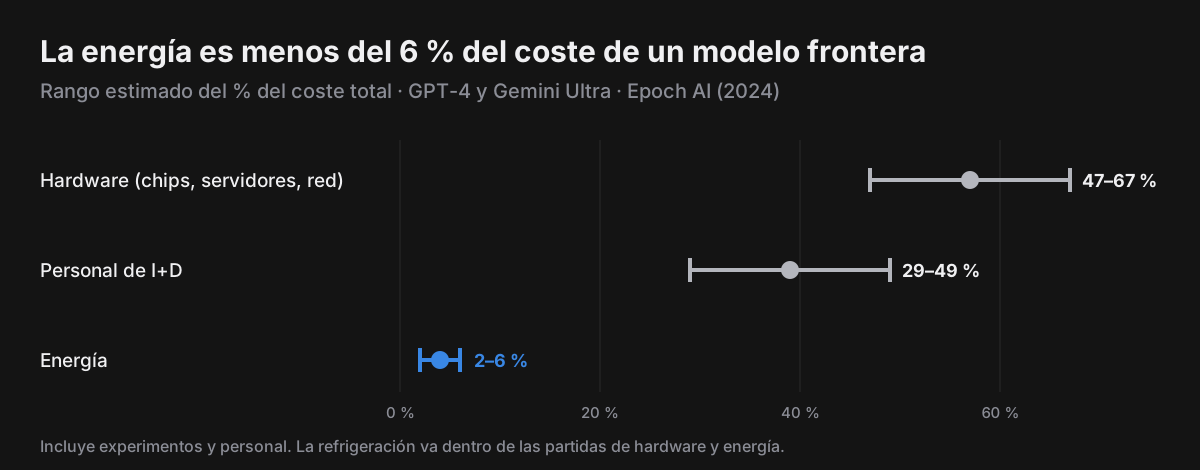
Los costes dependen mucho de los servidores y sistemas que se requieran, pero en general oscilan desde unos cientos de miles de dólares en modelos pequeños hasta cientos de millones en los modelos frontera, y crecen unas 2,4 veces al año. El desglose tiende a ser este, según la estimación de Epoch AI (se abre en una pestaña nueva) para GPT-4 y Gemini Ultra (publicada en 2024 y aún la más reciente con desglose por modelo):
- 47–67 % en hardware: amortización o alquiler de los sistemas capaces de entrenar esos modelos. Los «cerebros» son las tarjetas gráficas o GPU (en los modelos más avanzados, las de NVIDIA, como la H100 o la B200), más los servidores y la red de interconexión (NVLink, InfiniBand y cables de cobre y fibra) que conecta los diferentes sistemas.
- 29–49 % en personal de I+D: salarios y acciones de los investigadores e ingenieros.
- 2–6 % en consumo eléctrico. Miles de GPU funcionando al unísono pueden consumir más de 100–150 MW continuos, lo que consume una ciudad pequeña. Pero la electricidad es una parte pequeña del coste: el problema es conseguir esa capacidad conectada a la red, no su precio.
- Los sistemas de refrigeración (agua, aire u otros) van incluidos en las partidas de hardware y energía.
Dato actualizado (Epoch AI, agosto de 2026). Mirando la empresa entera y no un solo modelo, en Anthropic, MiniMax y Z.ai el cómputo (I+D más inferencia, es decir, más el coste de servir el modelo a los usuarios) supone más de la mitad de todos los gastos, entre el 54 % y el 62 %, mientras que el personal se queda por debajo del 25 %. Además, los gastos totales de estas empresas son de 2 a 3 veces sus ingresos (Epoch AI (se abre en una pestaña nueva)). Y el entrenamiento más caro registrado ya cuesta unas 10 veces más que GPT-4 en 2023 (datos de Epoch AI vía Dror Poleg (se abre en una pestaña nueva)).
La ejecución final es solo la punta del iceberg. De los ~5.000 M$ que OpenAI gastó en cómputo de I+D en 2024, solo ~500 M$ (≈10 %) fueron a las ejecuciones finales de modelos publicados; el resto, a experimentos y modelos no lanzados (Epoch AI (se abre en una pestaña nueva)). Para 2026, OpenAI se ha comprometido a gastar unos 50.000 M$ en cómputo (Epoch AI (se abre en una pestaña nueva)). Para un inversor, la cifra relevante es el gasto anual en I+D, no el coste de «un modelo».
Paralelización: por qué un modelo no cabe en una sola GPU
Para hacerte una idea de la envergadura del proceso: las máquinas no trabajan aisladas, sino en clusters (muchos servidores que actúan como uno solo), y deben trabajar en paralelo.
Con un modelo de 400.000 millones de parámetros es imposible que una sola memoria de GPU lo contenga, así que hay que repartir el modelo: el «cerebro» se fragmenta en trozos más pequeños, cada uno ejecuta una parte al mismo tiempo y, cada poco tiempo, se sincronizan para sumar los cálculos y actualizar los parámetros globales.
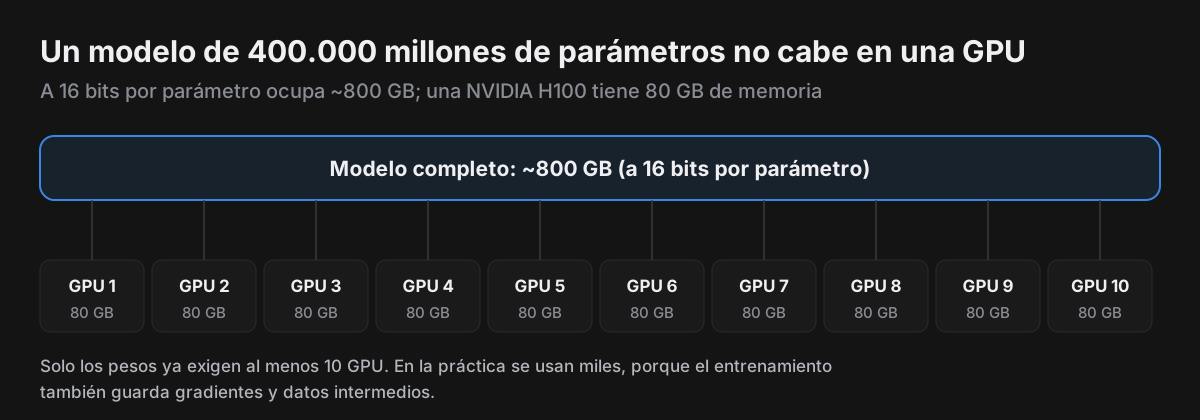
El dato concreto: 400.000 millones de parámetros a 16 bits (2 bytes cada uno) ocupan ~800 GB, y una H100 tiene 80 GB. Para repartir el trabajo se combinan cuatro tipos de paralelismo:
| Paralelismo | Qué se reparte |
|---|---|
| De datos | Cada grupo de GPU procesa datos distintos; luego promedian lo aprendido |
| Tensorial | Cada capa se divide entre varias GPU |
| De pipeline | Las capas se reparten en etapas, como una cadena de montaje |
| De expertos | En modelos MoE (mixture of experts), cada GPU aloja algunos «expertos» |
La interconexión combina NVLink dentro de cada servidor e InfiniBand o Ethernet de alto rendimiento entre servidores, con cables de cobre y ópticos. Es una pieza tan importante como los propios chips: si la red es lenta, las GPU esperan.
Checkpoints: guardar la partida
Los sistemas pueden fallar y, con ellos, estropearse toda la información, perdiendo millones de dólares de trabajo. Para evitarlo se usan checkpoints: cada cierto tiempo, o ante ciertos supuestos, los ingenieros guardan una copia del estado del entrenamiento. Así, si una o varias tarjetas fallan a la vez porque se queman, la red cae o la lectura de memoria da un error, se retoma desde la última copia. Es como guardar la partida en un videojuego.
Con decenas de miles de GPU, los fallos de hardware son diarios. La frecuencia de los checkpoints es un equilibrio: guardar a menudo cuesta tiempo de cálculo; guardar poco arriesga perder horas de trabajo.
Fase 2: ajuste fino supervisado (SFT), aprender a responder como un asistente
Tras el pre-entrenamiento, el modelo sabe mucho, pero solo sabe autocompletar texto. En el ajuste fino supervisado (SFT, supervised fine-tuning) se le enseña, con todo lo que ya sabe, cómo funciona la dinámica de una tarea concreta: por ejemplo, una conversación. Hay tres maneras de hacerlo:
- Mediante otros modelos o sistemas de plantillas se le dice cómo debe trabajar, con indicaciones o instrucciones, a la vez que se combinan las reglas operativas. El objetivo es que la IA vea multitud de conversaciones para que sepa exactamente cómo se piden las cosas, de qué manera le van a preguntar los usuarios y, con ello, qué debe responder.
- Se recopilan conversaciones de pregunta y respuesta: algunas de foros o FAQ y, sobre todo, respuestas escritas por expertos humanos o generadas por otros modelos y filtradas. Son conjuntos seleccionados y relativamente pequeños; el barrido masivo de internet corresponde al pre-entrenamiento.
- Reglas y modelos juez, para cuando se extraen muchas conversaciones y en ellas hay errores o alucinaciones. Se aplican filtros duros: eliminar las respuestas demasiado cortas (de menos de cierto número de palabras), eliminar las que contienen palabras prohibidas o crear otro modelo de IA que evalúa la calidad de cada respuesta de 0 a 10 y descarta las que no llegan a la nota mínima.
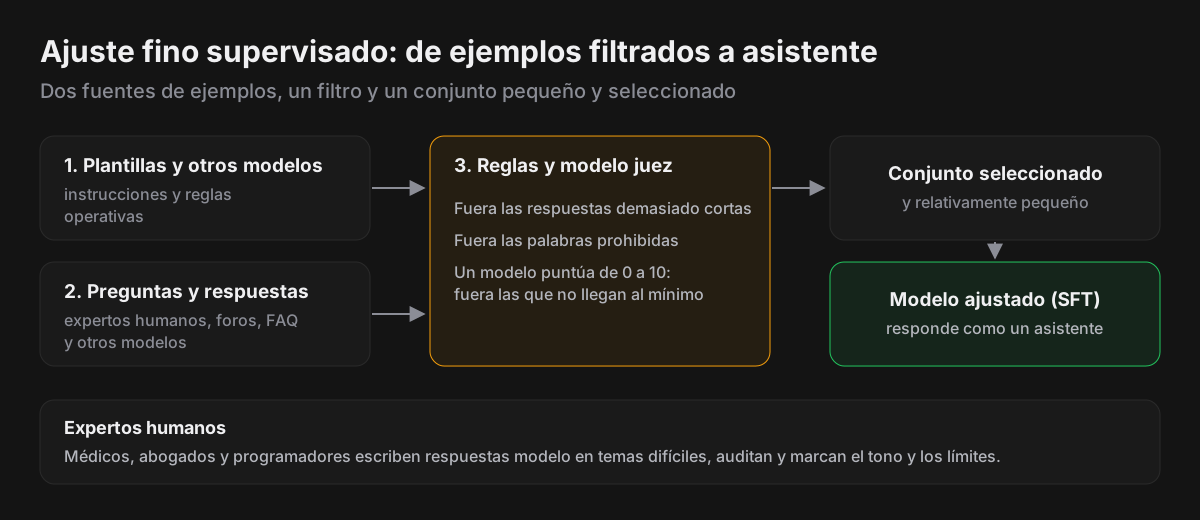
Los humanos tienen un papel importante: expertos contratados (médicos, abogados, programadores) escriben respuestas modelo en temas difíciles, auditan los resultados y marcan el tono que debe emplear la IA y los límites que debe respetar.
La tendencia de 2025–2026 son los datos sintéticos: un modelo potente genera ejemplos, otro los filtra y con ellos se entrena al siguiente. Abarata mucho el proceso, pero tiene un riesgo: si se recicla demasiado contenido generado por IA, los modelos pueden perder diversidad y calidad.
Fase 3: alineación (RLHF, DPO y razonamiento)
La tercera fase corrige el tono, evita el daño y enseña a razonar mejor. Su objetivo es resolver lo que en la industria se conoce como el problema de alineación: lograr que la IA sea útil (helpful), honesta (honest) y no dañina (harmless), y evitar que responda con insultos, alucinaciones, sesgos o instrucciones para fabricar algo peligroso.
El método clásico: RLHF (aprendizaje por refuerzo con feedback humano)
Históricamente (desde ChatGPT-3.5), el estándar para alinear una IA ha sido el RLHF. Este proceso no enseña contenidos nuevos a la red, sino que ajusta sus «frenos y aceleradores» mediante un sistema de recompensas de tipo estímulo-respuesta, parecido a cómo se entrena a una mascota. Funciona en cuatro pasos y un bucle:
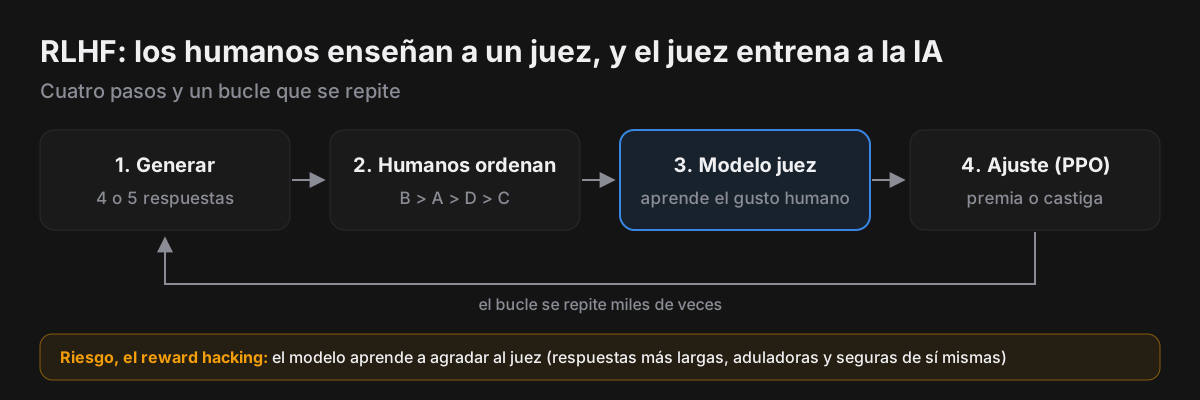
- Generación de variantes: el modelo recibe una pregunta y genera 4 o 5 respuestas diferentes.
- Evaluación humana (ranking): un equipo de evaluadores humanos analiza esas respuestas y las clasifica de mejor a peor (por ejemplo, B > A > D > C).
- Creación del modelo de recompensa (reward model): se entrena una segunda red neuronal para que «aprenda los gustos humanos». Esta red secundaria analiza qué hizo que la respuesta B fuera mejor que la A.
- Optimización con RL (PPO): la IA principal genera miles de respuestas en bucle. El modelo de recompensa le da una «puntuación» positiva si responde bien o una penalización si responde mal, y el modelo ajusta sus parámetros para buscar siempre la máxima puntuación.
El riesgo conocido del RLHF es el reward hacking: el modelo aprende a agradar al juez en lugar de ser útil (respuestas más largas, más aduladoras, más seguras de sí mismas). Es una de las raíces de la complacencia excesiva y de parte de las alucinaciones, como verás más abajo.
La evolución moderna: DPO (Direct Preference Optimization)
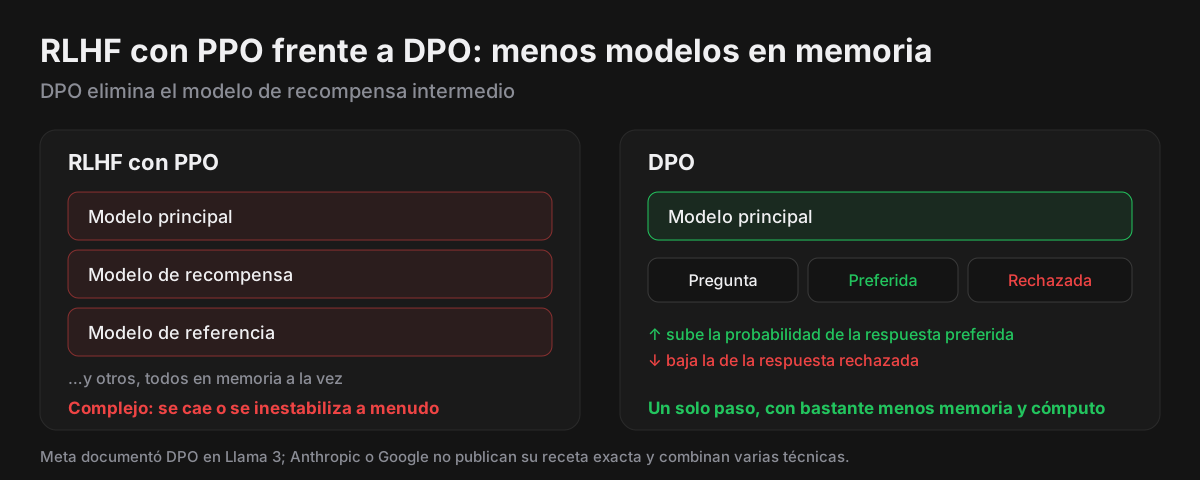
El RLHF con PPO es un sistema muy complejo porque exige mantener varios modelos gigantes en memoria a la vez (el modelo principal, el modelo de recompensa, el modelo de referencia, etc.), lo que hace que se caiga o se inestabilice con frecuencia durante el entrenamiento.
Por eso muchos modelos recientes usan DPO (Meta lo documentó en Llama 3; laboratorios como Anthropic o Google no publican su receta exacta y combinan varias técnicas):
- ¿Qué cambia? Elimina la necesidad de entrenar un modelo de recompensa intermedio.
- Mecanismo: se le entregan al modelo tríos directos de pregunta, respuesta preferida y respuesta rechazada.
- Resultado: mediante una fórmula matemática simplificada, el modelo aumenta la probabilidad del texto preferido y reduce la del rechazado en un solo paso, con bastante menos memoria y cómputo que el RLHF con PPO.
RLAIF y Constitutional AI: alineación con ayuda de otra IA
Empresas como Anthropic, creadora de Claude, llevaron esto un paso más allá para reducir la dependencia de humanos a la hora de evaluar millones de respuestas, con la Constitutional AI (o RLAIF, aprendizaje por refuerzo con feedback de IA):
- La constitución: los desarrolladores escriben un documento con reglas éticas explícitas (por ejemplo: «elige siempre la respuesta que evite el racismo, sea transparente y no ayude en actividades ilegales»).
- Autocorrección: cuando el modelo responde a una pregunta compleja, una IA «juez» revisa la respuesta contra la constitución. Si infringe alguna regla, la propia IA la reescribe para corregirla.
- Menos humanos en el bucle: esas respuestas autocorregidas se usan para entrenar al modelo final mediante DPO o RL. Los humanos siguen escribiendo la constitución y supervisando el proceso.
Anthropic publicó una constitución nueva el 22 de enero de 2026, mucho más extensa que la lista de principios de 2023. Ordena las prioridades de Claude (ser ampliamente seguro, ético, cumplir las directrices de Anthropic y ser genuinamente útil), explica el porqué de cada valor en lugar de dar solo reglas y se usa directamente en el entrenamiento (anuncio (se abre en una pestaña nueva); texto completo (se abre en una pestaña nueva)).
El nuevo nivel: razonamiento por aprendizaje por refuerzo (RL)
A partir de modelos frontera como la serie o1/o3 de OpenAI o DeepSeek R1, la alineación dio un salto cualitativo hacia el razonamiento:
- Ya no se entrena solo que el tono sea educado o seguro, sino la capacidad de razonar paso a paso (chain of thought, cadena de pensamiento).
- Durante el entrenamiento por RL se le da al modelo un problema complejo de matemáticas o código cuya respuesta se puede verificar.
- Si el resultado final es correcto, el razonamiento que llevó a él recibe una recompensa positiva.
- Los pasos de verificación interna (como «espera, déjame revisar si este cálculo es correcto antes de responder») no se premian directamente: surgen solos porque aumentan la probabilidad de acertar. DeepSeek lo llamó el momento aha.
En qué se diferencian OpenAI, Anthropic, Google, xAI, Meta y DeepSeek
Aunque las tres fases son estándar, la diferencia entre los gigantes de la IA está en los datos con los que entrenan y en las filosofías de alineación que aplican:
| Modelo (empresa) | Enfoque distintivo de entrenamiento | Fuente de datos e infraestructura |
|---|---|---|
| ChatGPT (OpenAI) | Pioneros en RLHF a gran escala. Han introducido el entrenamiento de razonamiento por reinforcement learning (como la serie o1/o3), que recompensa las respuestas correctas a las que el modelo llega tras pensar internamente. | Datasets masivos de la web, acuerdos de licencias de contenido comercial y datos generados internamente. Infraestructura sobre Microsoft Azure, Oracle y otros proveedores; primer chip propio con Broadcom (2026). |
| Claude (Anthropic) | Constitutional AI (RLAIF). En lugar de depender únicamente de humanos que evalúan respuestas, usan una IA «juez» guiada por una constitución pública (renovada en enero de 2026). | En 2026 cerró con 1.500 M$ la demanda Bartz v. Anthropic por haber descargado libros pirateados (Bloomberg Law (se abre en una pestaña nueva)); entrenar con libros comprados legalmente se consideró uso legítimo. Infraestructura mixta: TPU de Google, Trainium de AWS y GPU de NVIDIA. |
| Gemini (Google) | Multimodalidad nativa. Desde la fase de pre-entrenamiento, el modelo no solo lee texto: procesa audio, imágenes, vídeo y código simultáneamente en la misma red neuronal. | Acceso al ecosistema global de datos de Google y entrenamiento sobre infraestructura propia (TPU), sin depender exclusivamente de GPU comerciales. |
| Grok (xAI) | Datos en tiempo real. Aprovecha la integración directa con la plataforma X (Twitter) para pre-entrenar y ajustar con sus datos en tiempo real; se posiciona comercialmente como un modelo con menos restricciones. | Infraestructura propia con clusters masivos (por ejemplo, Colossus) para procesar hilos, tendencias y código. |
Hay dos actores más que conviene seguir, porque publican los pesos de sus modelos:
| Empresa | Enfoque distintivo | Pesos del modelo |
|---|---|---|
| Meta (Llama) | Estrategia de pesos abiertos; DPO documentado públicamente | Abiertos |
| DeepSeek | Eficiencia extrema (arquitectura MoE, entrenamiento barato); R1 popularizó el RL de razonamiento abierto en enero de 2025 | Abiertos |
Los pesos son los parámetros ya entrenados del modelo. «Pesos abiertos» significa que cualquiera puede descargar y ejecutar el modelo en sus propios equipos. Para un inversor importa porque presiona a la baja los precios de los modelos cerrados.
Cómo se calcula el coste de los tokens
El coste de los tokens no es un número fijo, sino una relación entre el cómputo por token (operaciones matemáticas) y la arquitectura del modelo. Para entenderlo hay que distinguir dos momentos.
La fórmula base: tokens de entrada frente a tokens de salida
En los modelos de tipo Transformer (la arquitectura en la que se basan los grandes LLM actuales), procesar tokens requiere dos fases operativas con costes computacionales distintos:
| Tipo de token | Fase | Coste |
|---|---|---|
| Entrada (prompt o contexto) | Prefill (en paralelo) | Menor coste por token |
| Salida (generación) | Decode (secuencial) | Mayor coste por token |
- Tokens de entrada (input o prefill): se procesan todos de golpe, en paralelo. El procesador gráfico (GPU) aprovecha muy bien su memoria caché y optimiza el cálculo. Por eso el token de entrada es más barato (suele costar un 70–80 % menos).
- Tokens de salida (output o decode): se generan de uno en uno, de forma secuencial. Por cada nuevo token producido, la GPU debe leer los miles de millones de parámetros del modelo desde su memoria (VRAM). Esto causa un cuello de botella de ancho de banda de memoria y hace que el token de salida sea sensiblemente más caro.
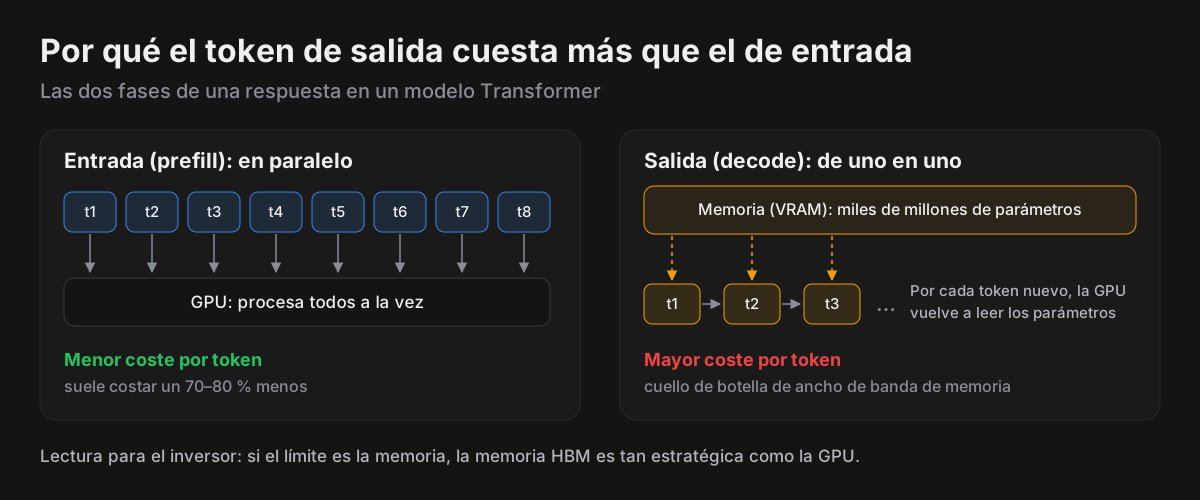
Esta explicación tiene una lectura de inversión directa: si el cuello de botella de la salida es la memoria, la memoria HBM (SK Hynix, Samsung, Micron) es tan estratégica como la propia GPU. Lo retomamos en la parte de inversión.
Cálculo económico directo: la factura de una API
La fórmula comercial estándar para calcular el coste de una consulta individual es:
Coste total = (tokens de entrada / 1.000.000) × precio de entrada
+ (tokens de salida / 1.000.000) × precio de salida
Los precios de las API se publican en dólares por millón de tokens ($/M).
Un modelo comercial a 3 $/M de entrada y 12 $/M de salida
- 01El usuario envía un texto de 2.000 tokens: 2.000 / 1.000.000 × 3 $ = 0,006 $.
- 02El modelo responde con 500 tokens: 500 / 1.000.000 × 12 $ = 0,006 $.
- 03Total: 0,006 $ + 0,006 $ = 0,012 $.
0,012 $ por consulta. Fíjate en que 500 tokens de salida cuestan lo mismo que 2.000 de entrada.
Estos son los precios oficiales de Anthropic a octubre de 2026, para aplicar la fórmula con datos reales:
| Modelo | Entrada ($/M tokens) | Salida ($/M tokens) | Entrada en caché ($/M) |
|---|---|---|---|
| Claude Fable 5.1 | 10 | 50 | 0,25 |
| Claude Opus 5.5 | 4 | 20 | 0,20 |
| Claude Sonnet 5.5 | 2 | 10 | 0,20 |
| Claude Haiku 4.5 | 1 | 5 | 0,10 |
Fuente: precios de Anthropic (se abre en una pestaña nueva). El mismo ejemplo con Claude Sonnet 5.5 costaría 2.000 / 1.000.000 × 2 $ + 500 / 1.000.000 × 10 $ = 0,004 $ + 0,005 $ = 0,009 $. Tres factores mueven la factura real:
- Caché de prompt: reutilizar un contexto ya procesado cuesta un 90–97 % menos que procesarlo de nuevo.
- API por lotes (batch): 50 % de descuento si aceptas una respuesta diferida.
- Tokens de razonamiento: los modelos que «piensan» facturan esos tokens como salida, y pueden multiplicar el coste.
Compara siempre con las páginas oficiales de OpenAI (se abre en una pestaña nueva) y Google (se abre en una pestaña nueva), que cambian varias veces al año.
El coste de la «memoria»: la KV cache
Cuando mantienes una conversación larga o usas un modelo con una ventana de contexto grande (como 1 millón de tokens), aparece un coste oculto: la KV cache (key-value cache).
Para no volver a recalcular todo el chat anterior en cada respuesta, la GPU guarda en su memoria (VRAM) las representaciones matemáticas de los mensajes anteriores. Cuanto más larga es la conversación, más memoria requiere cada usuario activo, lo que reduce el número de usuarios simultáneos que caben en un servidor y dispara el coste operativo.
Los proveedores trasladan este coste de formas distintas: Google y OpenAI cobran más por encima de cierto tamaño de contexto, mientras que Anthropic cobra lo mismo por token en toda la ventana de 1M de tokens desde Claude 4.6.
Usuarios gratuitos (freemium) y beneficio real
Para analizar la viabilidad económica de empresas como OpenAI, Google o Anthropic hay que aplicar la métrica de sostenibilidad de un modelo freemium (gratis con opción de pago) a un SaaS (software como servicio) de IA:
| Segmento | Qué genera |
|---|---|
| Usuarios gratuitos | Un coste directo diario (token burn o inferencia) |
| ↓ Tasa de conversión | En torno al 3–5 % pasa a pagar |
| Usuarios de pago (Pro o API) | Pagan una cuota fija (20 $/mes) o facturación por consumo (API) |
La métrica fundamental: coste de captación y de servicio frente al valor del cliente
En un SaaS se compara lo que cuesta conseguir y servir a un cliente (CAC, coste de captación, más el coste de servicio) con lo que deja a lo largo de su vida (LTV, lifetime value). En un software tradicional, un usuario gratuito cuesta casi 0 $ (solo espacio en una base de datos). En la IA, un usuario gratuito consume cómputo y electricidad reales en cada pregunta.
Para saber si el negocio da beneficio real se usa el margen bruto de inferencia:
Margen bruto = ingresos totales (suscripciones + API)
− costes de inferencia (usuarios gratuitos + de pago)
Cálculo del margen por usuario de pago (20 $/mes)
Imagina un plan Plus de 20 $/mes:
- Ingreso por usuario (ARPU): 20 $/mes.
- Coste del usuario de pago: si hace 50 consultas diarias con un modelo avanzado, le cuesta al laboratorio ~8–12 $ al mes en cómputo (es una hipótesis; es el coste de servir, que es menor que lo que costaría a precio de API).
- Subvención del usuario gratuito: si la tasa de conversión a pago es del 4 %, cada usuario de pago tiene que pagar su propio consumo más el de 24 usuarios gratuitos (96 gratuitos por cada 4 de pago).
Margen de un usuario de pago con un 4 % de conversión
- 01Coste de un usuario gratuito ≈ 0,30 $/mes → 24 × 0,30 $ = 7,20 $ de subvención.
- 02Uso propio del usuario de pago: 10 $ (punto medio de 8–12 $).
- 03Margen = 20 $ (ingreso) − 10 $ (uso propio) − 7,20 $ (subvención de los gratuitos) = 2,80 $.
2,80 $ de margen bruto de inferencia por usuario y mes. No incluye entrenamiento, I+D ni salarios, que es donde los laboratorios pierden dinero.
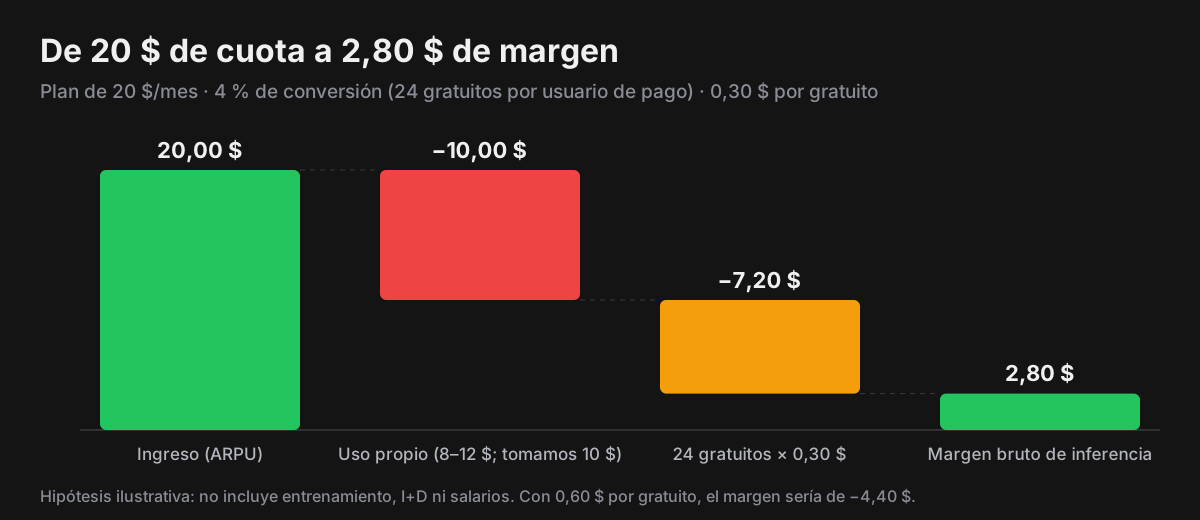
Si el uso del usuario gratuito o del usuario de pago supera ciertos límites, el margen se vuelve negativo: esa es la razón por la que existen los límites de mensajes por hora en ChatGPT o Claude.
Datos reales para contrastar el modelo
- Conversión: OpenAI comunicó en febrero de 2026 más de 900 millones de usuarios semanales y más de 50 millones de suscriptores de pago (≈5–6 %), y en julio de 2026 alcanzó ~1.000 millones de usuarios semanales (recopilación de Quashbugs con datos de OpenAI y The Verge (se abre en una pestaña nueva)). El rango del 3–5 % del ejemplo es coherente.
- Margen bruto real: según documentos para inversores publicados por The Information, el margen bruto ajustado de OpenAI fue del 33 % en 2025, frente al 40 % en 2024 y un objetivo interno del 46 %, porque el coste de inferencia se cuadruplicó (The Decoder (se abre en una pestaña nueva)). Para comparar: el software tradicional opera con márgenes brutos del 70–80 %.
- El mix importa. Los clientes empresariales y de API suelen pagar por uso, lo que protege el margen; el consumo de suscripción plana es el que más riesgo tiene con usuarios intensivos.
El mismo planteamiento (ingreso de 20 $ y uso propio de 10 $), variando la conversión y el coste de cada usuario gratuito, muestra lo sensible que es el resultado:
| Conversión | Gratuitos por cada usuario de pago | Gratuito a 0,15 $ | Gratuito a 0,30 $ | Gratuito a 0,60 $ |
|---|---|---|---|---|
| 3 % | 32 | 5,20 $ | 0,40 $ | −9,20 $ |
| 4 % | 24 | 6,40 $ | 2,80 $ | −4,40 $ |
| 5 % | 19 | 7,15 $ | 4,30 $ | −1,40 $ |
La lección: el margen es muy sensible al coste del usuario gratuito. Por eso los laboratorios limitan el plan gratuito, le asignan modelos más baratos y buscan monetizarlo por otras vías, como la publicidad que OpenAI ha empezado a probar.
Cómo fijan los límites de uso para que el usuario sea rentable
Los límites no se fijan pensando en el usuario medio, sino en la cola de usuarios intensivos. Unos pocos usuarios consumen una parte enorme del cómputo: con una suscripción plana de 20 $, un usuario que deja un agente programando todo el día puede costar decenas o cientos de veces su cuota.
Las palancas que usan los laboratorios:
- Límites por ventana de tiempo (mensajes cada pocas horas) y, desde 2025, también semanales: Anthropic los introdujo en agosto de 2025 tras detectar usuarios que mantenían Claude Code funcionando de forma continua.
- Escalera de planes: gratis → ~20 $ → planes de 100–200 $ con más uso. Cada escalón se fija para que el usuario típico de ese nivel tenga margen positivo.
- Enrutado de modelos: el plan gratuito y las preguntas sencillas van a modelos más baratos; los modelos caros se reservan para los planes de pago.
- Límites dinámicos: se endurecen en horas punta, cuando la capacidad de GPU escasea.
Suscripción o API: qué es más rentable para un laboratorio
| Suscripción (Plus, Pro, Max) | API | |
|---|---|---|
| Cómo se cobra | Cuota fija mensual | Por token consumido |
| Riesgo para el laboratorio | Los usuarios intensivos destruyen el margen | Bajo: el cliente paga lo que usa |
| Margen | Variable, depende del mix de usuarios | Más predecible |
| Quién lo usa | Consumidores y profesionales | Empresas y desarrolladores |
La API y los contratos empresariales son el negocio más sano en margen; la suscripción da escala, marca y datos de uso.
De dónde viene el dinero de OpenAI y de Anthropic
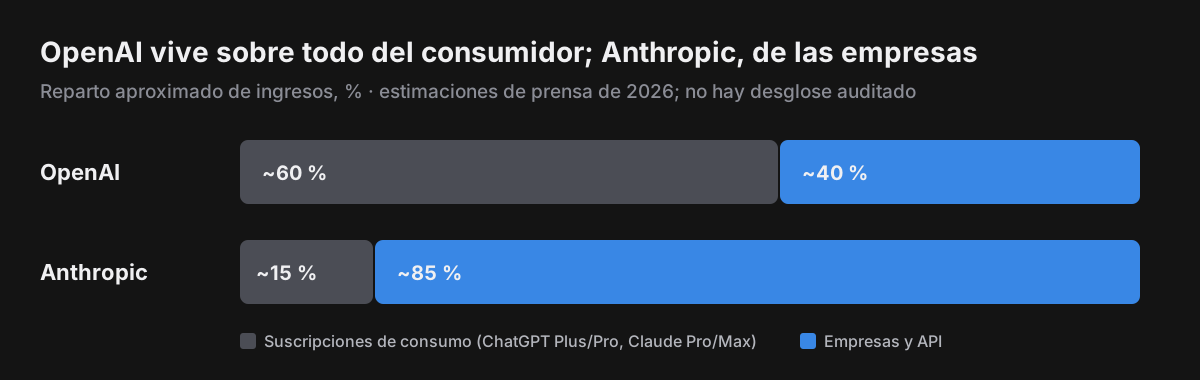
Las dos empresas venden lo mismo, pero a clientes distintos, y eso cambia su economía:
| Dato | OpenAI | Anthropic |
|---|---|---|
| Ingreso anualizado más reciente | Más de 40.000 M$ (agosto de 2026) | ~65.000 M$ (julio de 2026) |
| Peso del consumidor | ~60 %, con más de 50 millones de suscriptores | ~10–15 % |
| Peso de empresas y API | Más del 40 % y creciendo | ~85 %; la API por tokens sola, ~70–75 % |
| Cuota del gasto empresarial en API de LLM (finales de 2025) | ~27 % | ~40 % |
| Cuota en IA para programación | ~21 % | ~42–54 % |
| Usuarios gratuitos | Cientos de millones (~1.000 millones semanales en total) | Muchos menos |
Fuentes: Arcade.dev (se abre en una pestaña nueva) y Sentisight (se abre en una pestaña nueva), que citan datos de Menlo Ventures (inversor de Anthropic, conviene tenerlo en cuenta) y de Ramp. Según Semafor, las dos empresas contabilizan los ingresos con métodos distintos (en bruto o en neto de lo que cobran los socios de nube), así que la comparación directa es aproximada.
Lo que se sabe de los costes de cada una. Ninguna de las dos publica un desglose de costes por segmento. Lo que sí hay:
| Dato de costes | OpenAI | Anthropic |
|---|---|---|
| Margen bruto | 33 % ajustado en 2025 (40 % en 2024) | Sin cifra pública fiable |
| Coste de inferencia | Se cuadruplicó en 2025 | — |
| Peso del cómputo en el gasto total | — | 54–62 % (Epoch AI) |
| Gastos frente a ingresos | Quemó 3.700 M$ en el primer trimestre de 2026 con 5.700 M$ de ingresos | Gastos de 2 a 3 veces sus ingresos (Epoch AI); prevé beneficios en 2028 |
Fuentes: The Decoder (se abre en una pestaña nueva) y Epoch AI (se abre en una pestaña nueva).
Por qué el mix importa tanto: un usuario gratuito genera coste de inferencia y cero ingresos; un cliente de API paga cada token que consume. Por eso el modelo con más peso de empresas tiende a tener mejor margen por cada dólar ingresado, y por eso OpenAI está empujando su negocio empresarial y probando publicidad en el plan gratuito.
Los números de los dos líderes
- OpenAI: ingresos de ~13.100 M$ en 2025, más del triple que en 2024, y un ritmo anualizado de más de 40.000 M$ en agosto de 2026 según CNBC, pero con un margen bruto ajustado del 33 % y pérdidas crecientes por inferencia y entrenamiento. Planea gastar ~32.000 M$ en entrenamiento en 2026 (The Decoder (se abre en una pestaña nueva)). En marzo de 2026 cerró 122.000 M$ de financiación comprometida con una valoración de 852.000 M$.
- Anthropic: su ingreso anualizado pasó de ~9.000 M$ a finales de 2025 a más de 65.000 M$ a finales de julio de 2026, impulsado por clientes empresariales y Claude Code. En mayo de 2026 se valoró en 965.000 M$ tras levantar 65.000 M$ (Techeconomy (se abre en una pestaña nueva)). Son cifras de la propia compañía, no auditadas.
Cómo afectan los nuevos modelos como Jev
Jev es un modelo lanzado el 15 de septiembre de 2026 por TypeSafe AI, una startup de San Francisco. Su fundador, Diogo Almeida, trabajó cuatro años en OpenAI y es coautor del artículo de 2022 sobre RLHF que está en la base de ChatGPT (el método que has visto en la fase de alineación). Su tesis: los LLM son excelentes conversando, pero no sirven bien para automatizar, porque los ordenadores «hablan otro idioma» (BDM (se abre en una pestaña nueva), que recoge el anuncio de TypeSafe AI (se abre en una pestaña nueva) y la entrevista en TechCrunch).
- Qué es: el primer modelo de una categoría que la empresa llama System One Models. No genera texto: solo responde a tres tipos de preguntas cerradas. Choice elige una opción de una lista. Score puntúa según una rúbrica fijada de antemano. Noul estima la probabilidad de que una afirmación sea cierta. Por ejemplo, ante un comentario en una web, decide si es insultante, si es una pregunta, una crítica o spam, y lo puntúa de 1 a 5.
- Cómo se entrena: con un método nuevo, RLCD (Reinforcement Learning for Calibrated Decisions), que le enseña a dar su nivel de confianza de forma honesta, más una arquitectura propia que evalúa todas las preguntas de una petición en paralelo.
- Velocidad y coste (datos de la propia empresa): responde en 70–500 milisegundos; en sus pruebas internas, hasta 193 veces más rápido y 444 veces más barato que un LLM. La propia TypeSafe advierte que esas pruebas las diseñó su equipo y pueden tener sesgo.
- Precio: 0,042 $ por millón de tokens de entrada, y la salida es gratis. Como referencia, Claude Haiku 4.5 cobra 1 $ por millón de entrada: unas 24 veces más.
- ¿Alucina? Como su respuesta está limitada a un formato cerrado, no puede inventarse un texto. Pero sí puede equivocarse: la confianza que devuelve sirve para medir ese riesgo. Que sea «inmune a las alucinaciones» es un mensaje comercial.
- Pruebas externas: según ingenieros citados por TechCrunch, en tareas concretas (revisar la seguridad de comandos, clasificar correos) rinde al nivel de GPT-5.6 Luna o Gemini, a veces con algo menos de precisión, pero a un coste mucho menor.
- El nombre: es un homenaje a William Stanley Jevons, el economista de la paradoja de Jevons: abaratar un recurso dispara su consumo.
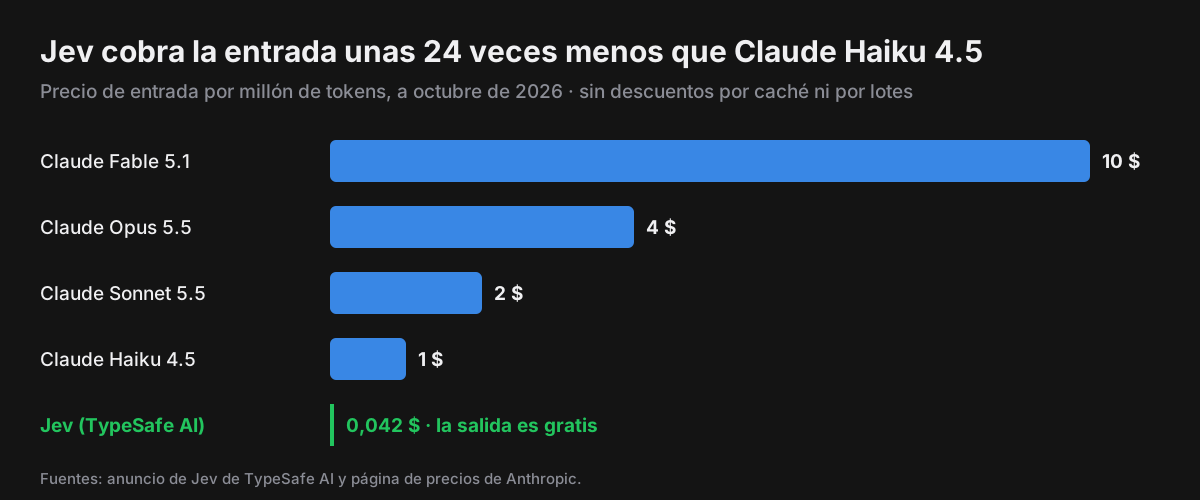
Jev frente a un LLM, punto por punto
| LLM (GPT, Claude, Gemini) | Jev | |
|---|---|---|
| Entrenamiento posterior | RLHF y RL con resultados verificables | RLCD: decisiones calibradas |
| Qué se premia | Respuestas que prefieren los humanos o que se pueden comprobar | Que las probabilidades que da sean honestas |
| Entrada | Texto, como conversación en mensajes | Un «estado» (texto o datos) más preguntas definidas de antemano |
| Salida | Texto libre que hay que interpretar | Una opción, un nivel o una probabilidad, siempre con su confianza |
| Cómo genera | Token a token, en secuencia (decode) | Todas las respuestas a la vez, en una sola consulta |
| Tiempo de respuesta | De 3 a 329 segundos en modelos frontera, según la medición que cita TypeSafe | 70–500 milisegundos |
| Precio de entrada | De 0,20 a 10 $ por millón de tokens | 0,042 $ |
| Precio de salida | Unas 5 veces el de entrada | Gratis |
| ¿Puede inventar? | Sí: texto, datos o formatos erróneos | No puede salirse del formato, pero sí equivocarse de opción |
| Para qué sirve | Chat, copilotos, agentes de programación, problemas comprobables | «If inteligentes» dentro del software: clasificar, enrutar, puntuar, verificar y procesar grandes volúmenes de datos |
Fuente: anuncio de TypeSafe AI (se abre en una pestaña nueva). En su demostración, TypeSafe lo compara con GPT-5.6 Terra, el modelo que considera más parecido en inteligencia, y en sus pruebas de flujos de trabajo usa como referencia la media de GPT-6 Astra y Claude Fable 5.1.
Cómo decide que algo es un 0, un 1 o un 2: un ejemplo real
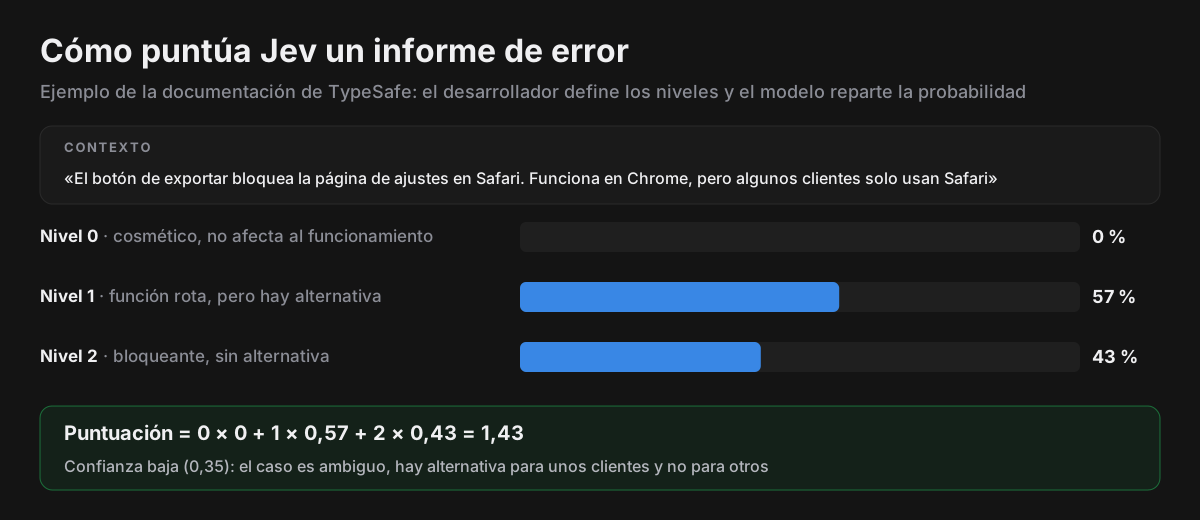
En un LLM, el modelo escribe la respuesta palabra a palabra. En Jev, la escala la defines tú y el modelo reparte la probabilidad entre los niveles. El ejemplo está sacado de la documentación de TypeSafe (se abre en una pestaña nueva):
- El contexto (state) es el texto a evaluar. Por ejemplo, un informe de error: «El botón de exportar bloquea la página de ajustes en Safari. Funciona en Chrome, pero algunos clientes solo usan Safari».
- La pregunta y los niveles (criteria) los escribe el desarrollador, describiendo situaciones: nivel 0, cosmético, no afecta al funcionamiento; nivel 1, función rota o degradada, pero hay alternativa; nivel 2, bloqueante, sin alternativa.
- El modelo compara el contexto con cada descripción por separado (no ve los números ni los niveles vecinos) y devuelve una probabilidad para cada nivel: 0 % al 0, 57 % al 1 y 43 % al 2.
- La puntuación es la media ponderada: 0 × 0 + 1 × 0,57 + 2 × 0,43 = 1,43.
- La confianza sale de lo repartida que está la probabilidad: aquí es baja (0,35) porque el caso es ambiguo, ya que hay alternativa para unos clientes pero no para otros.
Así cambia la respuesta con distintos informes y la misma pregunta:
| Informe recibido | Puntuación | Confianza |
|---|---|---|
| El botón de exportar está desalineado unos píxeles | 0,0 | 1,0 |
| Exportar a PDF no hace nada; puedo exportar a CSV y convertirlo, pero tardo mucho | 1,0 | 1,0 |
| Exportar a PDF se queda cargando; a unos el CSV les funciona y a otros no | 1,11 | 0,84 |
| Falla en Safari, funciona en Chrome, pero algunos clientes solo usan Safari | 1,43 | 0,35 |
| Nadie del equipo puede iniciar sesión desde esta mañana; error 500 | 2,0 | 1,0 |
La prueba de que no «entiende números»: si en lugar de describir los niveles solo se escribe «0», «1» y «2», el informe del botón desalineado pasa de una puntuación de 0,0 con confianza 1,0 a 0,55 con confianza 0,33. El modelo necesita descripciones concretas con las que comparar el texto. La lógica de fondo recuerda a la vectorización del pre-entrenamiento: gana el nivel cuya descripción se parece más al contexto.
Para decisiones complejas, se descompone. En vez de preguntar «¿qué prioridad tiene esta incidencia?», se hacen tres preguntas a la vez (gravedad, enfado del cliente y calidad del informe) y el propio programa las combina con pesos fijados por el equipo. En el ejemplo de la documentación: 0,6 × gravedad + 0,3 × enfado + 0,1 × calidad = 0,66. Si la prioridad no convence, se cambia un peso en el código, no el modelo.
Por qué se entrena así: la calibración
Un modelo está calibrado cuando sus probabilidades coinciden con la realidad: de todas las veces que dice «80 %», acierta en torno al 80 %. Es lo que permite automatizar: el programa actúa solo cuando la confianza es alta y pasa a un humano los casos dudosos.
Los LLM no lo están por defecto. El RLHF premia lo que prefieren los humanos, y a los humanos les gustan las respuestas seguras, así que el modelo aprende a sonar convencido aunque no lo esté (lo verás en la sección de alucinaciones). TypeSafe añade otro problema: el RLHF estrecha la variedad de respuestas del modelo (lo llama mode dropping).
TypeSafe no publica los detalles de su RLCD. La forma estándar de premiar probabilidades honestas es una regla de puntuación propia, como la pérdida logarítmica: la penalización es el logaritmo natural, cambiado de signo, de la probabilidad que el modelo dio a la respuesta correcta. Un ejemplo ilustrativo de la técnica (no de la receta de TypeSafe), si la respuesta correcta es el nivel 1:
| Lo que dice el modelo | Penalización (−ln de la probabilidad del nivel correcto) |
|---|---|
| 100 % al nivel 1 (seguro y acierta) | 0 |
| 57 % al nivel 1 (duda, pero se inclina bien) | 0,56 |
| 10 % al nivel 1 (se inclina mal) | 2,30 |
| 1 % al nivel 1 (seguro y se equivoca) | 4,61 |
Con esta regla, lo que más castiga es estar muy seguro y equivocarse, así que al modelo le conviene decir exactamente lo seguro que está. Es la diferencia con un examen que solo cuenta aciertos.
Un ejemplo para traders: filtrar titulares
Así podrías plantear en Jev un filtro de noticias para tu operativa (diseño ilustrativo, no un resultado real):
- Contexto: el titular y el primer párrafo de la noticia.
- Choice: ¿de qué tipo es? Resultados, acuerdo comercial, regulación o cambio en la dirección.
- Score: ¿qué impacto tiene en los ingresos? 0: ninguno concreto; 1: menos del 5 % de las ventas; 2: entre el 5 % y el 20 %; 3: más del 20 %.
- Noul: «La noticia anuncia un contrato de cómputo de al menos 1 GW» (verdadero o falso, con su probabilidad).
Tu programa solo te avisa si el tipo es «acuerdo», el impacto es 2 o más y la confianza supera el umbral que tú fijes. Con un LLM se puede hacer lo mismo, pero tarda segundos por noticia, cuesta más y hay que comprobar que el texto que devuelve tiene el formato correcto.
Lectura para el inversor
- Presión sobre los laboratorios. Buena parte del uso de API dentro de automatizaciones y agentes son decisiones cortas (clasificar, aprobar, puntuar). Si se resuelven con un modelo decenas o cientos de veces más barato, baja el ingreso por tarea de OpenAI, Anthropic o Google en ese segmento.
- No reduce la demanda de cómputo. Por la propia paradoja de Jevons, lo más probable es que se automaticen muchas más tareas, no que se gaste menos en total.
- No es invertible directamente. TypeSafe es privada (la prensa coreana informa de que busca unos 1.000 M$ de financiación). La señal a vigilar es si grandes plataformas de software lo adoptan.
- Está en acceso anticipado y sus cifras no están verificadas de forma independiente.
Otra alternativa a los LLM que conviene conocer: JEPA, la arquitectura de Yann LeCun para modelos del mundo (robótica, vídeo, razonamiento físico). Su empresa, AMI Labs, levantó 1.030 M$ en marzo de 2026, pero dice que tardará años en llegar al mercado (SiliconANGLE (se abre en una pestaña nueva)).
Por qué alucinan los modelos de IA
Una alucinación es una respuesta falsa dicha con apariencia de verdad: un dato, una cifra o una cita inventados. OpenAI publicó en septiembre de 2025 un análisis que lo explica con dos causas (OpenAI (se abre en una pestaña nueva)):
- Hechos arbitrarios. En el pre-entrenamiento el modelo solo ve texto, sin etiquetas de verdadero o falso. Aprende bien lo que sigue patrones (gramática, código), pero no puede deducir datos sueltos que aparecieron pocas veces, como la fecha de cumpleaños de alguien poco conocido. Ahí «rellena» con algo plausible.
- Los incentivos premian adivinar. Los benchmarks puntúan solo aciertos: como en un examen tipo test sin penalización, contestar al azar sube la nota y decir «no lo sé» da cero.
El ejemplo de OpenAI con su test SimpleQA:
| Métrica | gpt-5-thinking-mini | o4-mini |
|---|---|---|
| No contesta | 52 % | 1 % |
| Acierta | 22 % | 24 % |
| Se equivoca (alucina) | 26 % | 75 % |
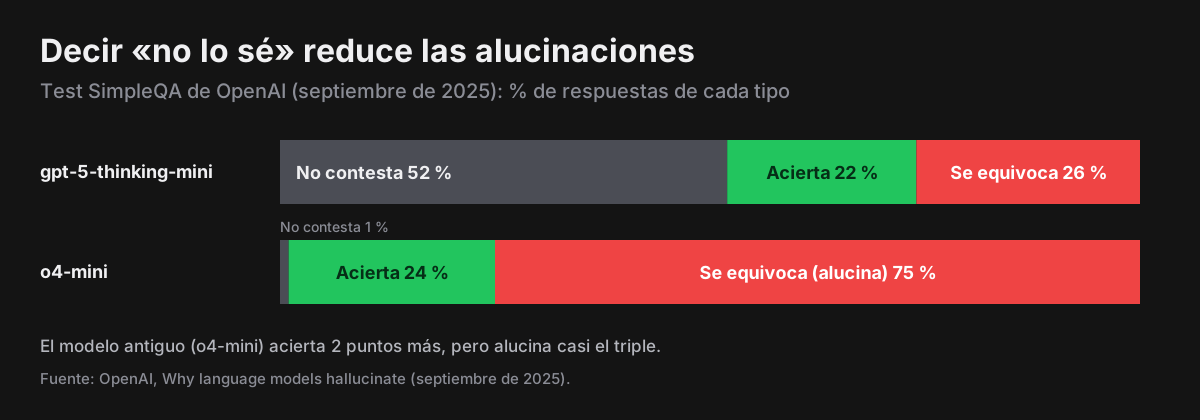
El modelo antiguo gana en aciertos por 2 puntos, pero alucina casi el triple. A eso se suma la complacencia aprendida con el RLHF (el reward hacking de la fase de alineación).
Benchmarks: cómo se comparan los modelos de IA
Los benchmarks son exámenes estandarizados para comparar modelos. Los que más se siguen hoy:
| Benchmark | Qué mide |
|---|---|
| SWE-bench Verified | Resolver incidencias reales de código en GitHub |
| GPQA Diamond | Preguntas científicas de nivel doctorado |
| Humanity's Last Exam | Preguntas de frontera en muchas disciplinas |
| ARC-AGI | Razonamiento abstracto con patrones nuevos |
| FrontierMath (Epoch AI) | Matemáticas de investigación |
| METR (horizonte temporal) | Duración de las tareas que un agente completa de forma autónoma |
| LMArena | Preferencia humana en comparaciones a ciegas |
Cuidado al leerlos: se saturan rápido (los modelos llegan al 90 % y dejan de distinguir), pueden estar contaminados (las preguntas aparecen en los datos de entrenamiento) y los laboratorios eligen los que les favorecen. Para seguirlos de forma neutral: Epoch AI Benchmarks (se abre en una pestaña nueva) y Artificial Analysis (se abre en una pestaña nueva), que además compara precio y velocidad.
Coste e infraestructura energética de la IA
- Los centros de datos consumieron unos 416 TWh en 2024 (≈1,5 % de la electricidad mundial) y unos 485 TWh en 2025. La Agencia Internacional de la Energía proyecta 945 TWh en 2030, más que todo el consumo actual de Japón, con la IA como principal motor (IEA, Energy and AI (se abre en una pestaña nueva)).
- Un centro de datos de 100 MW consume tanta electricidad como 100.000 hogares. Los nuevos campus de IA se planifican ya en gigavatios (1 GW = 1.000 MW).
- En EE. UU., el procesamiento de datos consumirá en 2030 más electricidad que toda la industria intensiva (acero, aluminio, cemento, química).
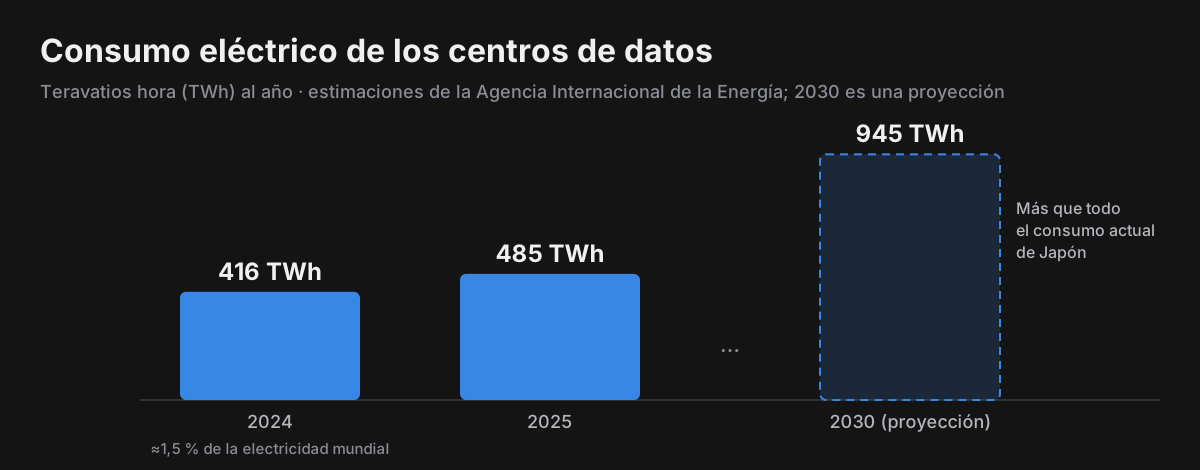
La conclusión para invertir: la energía pesa poco en el coste de entrenar (2–6 %, como has visto en el pre-entrenamiento), pero es el cuello de botella físico. Conectar un campus de 1 GW a la red lleva años, lo que beneficia a quien ya tiene energía disponible: generadores eléctricos, nuclear, gas, redes y equipos de refrigeración y eléctricos.
Invertir en IA: dónde está el dinero
Todo lo anterior (tokens, entrenamiento, inferencia) se traduce en un flujo de dinero que baja por una cadena de capas. Entender quién cobra y quién paga en cada capa es la base para invertir con criterio.
La cadena de valor
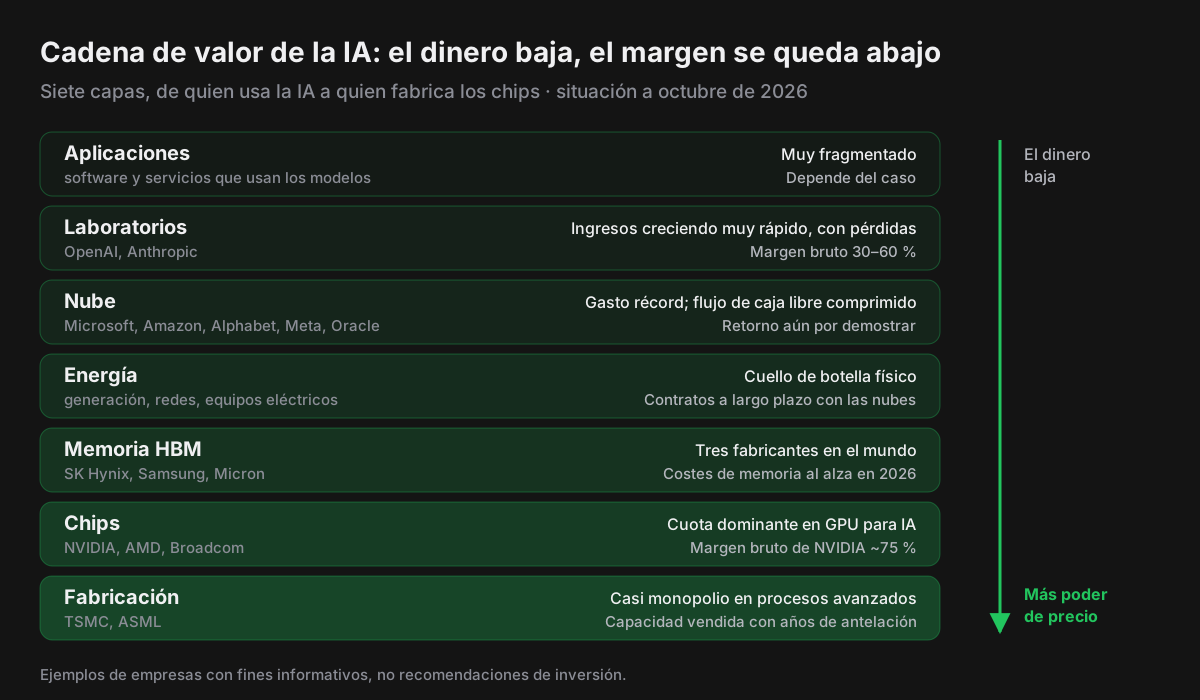
Hoy el margen se concentra en la parte baja de la cadena, donde hay pocos proveedores y la demanda supera a la oferta:
| Capa | Situación actual | Señal de poder de precio |
|---|---|---|
| Fabricación (TSMC, ASML) | Casi monopolio en procesos avanzados | Capacidad vendida con años de antelación |
| Chips (NVIDIA) | Cuota dominante en GPU para IA | Margen bruto ~75 % |
| Memoria HBM | Tres fabricantes en el mundo | Costes de memoria al alza en 2026 |
| Energía | Cuello de botella físico | Contratos a largo plazo con los hyperscalers |
| Nube | Gastan cifras récord; su flujo de caja libre se comprime | Retorno aún por demostrar |
| Laboratorios | Ingresos creciendo muy rápido, con pérdidas | Margen bruto 30–60 % |
| Aplicaciones | Muy fragmentado | Depende del caso |
Los hyperscalers son las grandes nubes que construyen centros de datos a escala masiva; en este contexto, Amazon, Microsoft, Alphabet (Google) y Meta. El margen bruto es lo que queda de cada dólar de ventas tras pagar el coste directo de lo vendido.
NVIDIA como termómetro. En su trimestre cerrado el 26 de julio de 2026 facturó 96.200 M$ (+106 % interanual), de los que 89.000 M$ fueron de centros de datos (+117 %), con un margen bruto del 75 %. Su previsión para el siguiente trimestre es de 108.000 M$, sin contar ventas de centros de datos a China, y anticipa que el margen bajará a la zona del 71–72 % por el encarecimiento de la memoria (NVIDIA (se abre en una pestaña nueva); Rivkin (se abre en una pestaña nueva)).
El capex de los hyperscalers
El capex (capital expenditure) es la inversión en activos físicos: centros de datos, servidores, chips. Las previsiones de capex para 2026 según los resultados del primer trimestre, en millones de dólares: Amazon ~200.000; Microsoft ~190.000; Alphabet 180.000–190.000; Meta 125.000–145.000 (Yahoo Finance (se abre en una pestaña nueva); The Next Web (se abre en una pestaña nueva)).
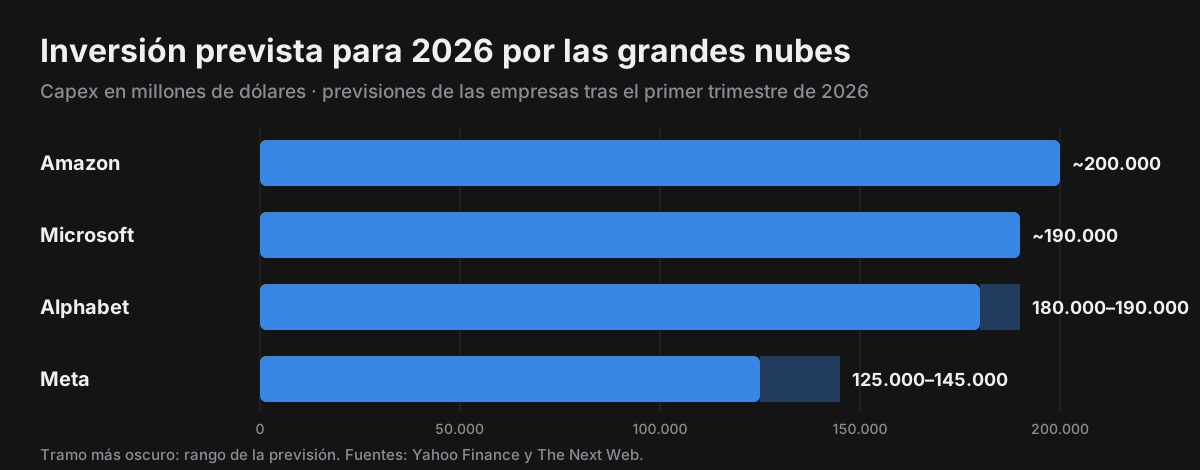
Lo que debe vigilar un inversor no es el capex en sí, sino su efecto en el flujo de caja libre (el dinero que queda después de pagar la operación y las inversiones): el de Amazon en los últimos doce meses cayó un 95 %, y unas dos terceras partes del capex trimestral de Microsoft fueron a activos de vida corta (GPU y CPU), que se deprecian rápido (Om Malik (se abre en una pestaña nueva)).
La pregunta de los 600.000 millones, actualizada
En junio de 2024, David Cahn (Sequoia) planteó un cálculo sencillo para medir la brecha entre la inversión en IA y los ingresos que debería generar (Sequoia (se abre en una pestaña nueva)):
- Tomar los ingresos anualizados de NVIDIA en centros de datos.
- Multiplicar por 2: las GPU son la mitad del coste total de un centro de datos (el resto es energía, edificios, etc.).
- Multiplicar por 2 otra vez: quien usa esas GPU necesita un margen bruto del 50 %.
El resultado es el ingreso final de IA necesario para justificar la inversión. En 2024 salían 600.000 millones de dólares.
Aplicado a hoy (ejercicio ilustrativo)
- 01Ingresos de NVIDIA en centros de datos: 89.000 M$ trimestrales × 4 = ~356.000 M$ anualizados.
- 02× 2 (las GPU son la mitad del coste del centro de datos) × 2 (margen bruto del 50 %) ≈ 1,4 billones de dólares.
- 03Frente a eso, los dos grandes laboratorios suman ya más de 100.000 M$ de ingresos anualizados (Anthropic ~65.000 a finales de julio y OpenAI más de 40.000 en agosto de 2026).
Harían falta ≈1,4 billones de dólares de ingresos anuales de IA. A los laboratorios hay que añadir los ingresos de IA de las nubes, Meta (publicidad) y las aplicaciones. La brecha sigue siendo grande, aunque los ingresos crecen mucho más rápido que en 2024.
Los ingresos de los laboratorios
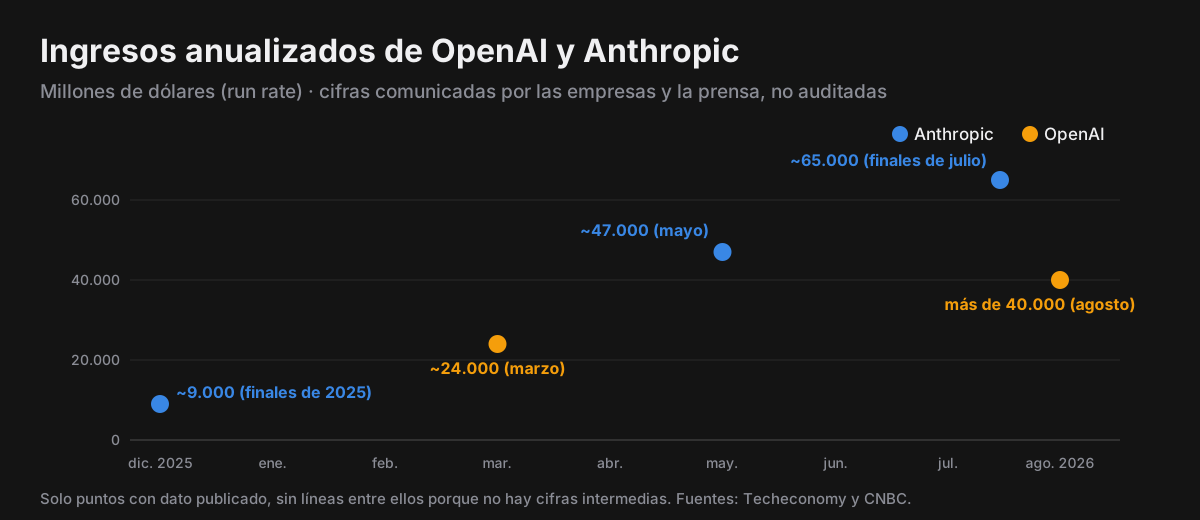
Como referencia, OpenAI pasó de ~24.000 M$ anualizados en marzo de 2026 a más de 40.000 M$ en agosto, según CNBC. Anthropic la superó en ingresos en primavera, pero ambas crecen muy rápido.
Es la otra cara de la brecha: ninguna empresa de software ha crecido así. La pregunta para el inversor es si ese crecimiento se sostiene con márgenes que mejoren, o si el coste de inferencia crece al mismo ritmo (como le ocurre a OpenAI, según has visto en la sección de usuarios gratuitos).
Cómo analizar una empresa de IA y qué riesgos vigilar
Métricas por eslabón
| Eslabón | Métricas clave | Qué te dicen |
|---|---|---|
| Chips (NVIDIA, AMD, Broadcom) | Ingresos de centros de datos, margen bruto, guía del trimestre siguiente, inventario, concentración de clientes | Si la demanda sigue superando a la oferta y si el poder de precio aguanta |
| Memoria y fabricación (SK Hynix, Micron, TSMC) | Precio de HBM, utilización de capacidad, capex propio | Dónde están los cuellos de botella |
| Nube (Microsoft, Amazon, Alphabet, Meta, Oracle) | Crecimiento de la nube, capex/ingresos, flujo de caja libre, cartera de pedidos (backlog), vida útil de los servidores | Si la inversión empieza a rentar |
| Laboratorios (en bolsa o vía rondas) | Ingreso anualizado, margen bruto, coste de inferencia/ingresos, mix empresa/consumo, retención | Si el modelo de negocio escala con margen |
| Energía | Contratos firmados con centros de datos, MW conectados, plazos de conexión a la red | Quién monetiza el cuello de botella físico |
| Aplicaciones | Ingresos por IA, coste por tarea, pérdida de clientes frente a los laboratorios | Si tienen ventaja propia o dependen del modelo de otro |
Cuatro preguntas que conectan todo esto con una inversión
- ¿Paga o cobra por cómputo? Quien vende GPU, memoria o energía cobra hoy; quien alquila cómputo para servir modelos paga y asume el riesgo de margen (lo has visto en el coste de los tokens y en la economía del freemium).
- ¿Su coste de inferencia baja más rápido que su precio? Si el precio por token cae (competencia, modelos abiertos) más rápido que el coste, el margen se comprime.
- ¿Depende de un solo cliente o de un solo proveedor? NVIDIA vende la mitad de sus centros de datos a pocas nubes; muchas aplicaciones dependen de la API de un laboratorio.
- ¿Cómo cuenta los ingresos? «Anualizado» no es «anual». Busca cifras auditadas o reportadas.
Riesgos a vigilar
- Depreciación de las GPU. Cada generación (Hopper → Blackwell → Rubin) mejora mucho el rendimiento por dólar y deja obsoleta la anterior. Si los hyperscalers amortizan los servidores en 5–6 años pero su vida económica real es de 2–3, sus beneficios contables están inflados. Es una advertencia que Sequoia ya planteaba en 2024.
- Acuerdos circulares. Proveedores que invierten en sus propios clientes (por ejemplo, NVIDIA participando en laboratorios que luego le compran chips) pueden inflar la demanda aparente. Revisa siempre de dónde sale el dinero del cliente.
- Financiación con deuda. El capex ya supera al flujo de caja de varias tecnológicas, y empiezan a emitir bonos (Alphabet colocó 25.000 M$ en 2026). Más deuda significa más sensibilidad a los tipos de interés.
- Valoraciones. Anthropic se valoró en 965.000 M$ en mayo de 2026, con ~47.000 M$ de ingreso anualizado (≈20 veces; ≈15 veces sobre los ~65.000 M$ de julio); OpenAI, en 852.000 M$. Exigen años de crecimiento muy alto sin tropiezos.
- Geopolítica y regulación. NVIDIA ya excluye a China de sus previsiones. Los controles de exportación también afectan a los modelos: en junio de 2026, Anthropic tuvo que suspender temporalmente el acceso a Claude Fable 5 y Mythos 5 para cumplir controles del Departamento de Comercio de EE. UU., levantados el 30 de junio (Anthropic (se abre en una pestaña nueva)).
- Energía y plazos. Un retraso en la conexión eléctrica retrasa los ingresos de la nube aunque las GPU ya estén compradas.
- Deflación de precios. Los modelos de pesos abiertos (DeepSeek, Llama) presionan los precios de API a la baja: bueno para los usuarios, malo para los márgenes de los laboratorios.
- Cambio de paradigma. Si modelos alternativos como Jev o JEPA sustituyen a los LLM en parte de sus usos, cambiaría quién gana entre los laboratorios, aunque probablemente no la demanda de cómputo.
Cuatro escenarios
| Escenario | Qué pasaría | Quién gana | Quién pierde |
|---|---|---|---|
| Los ingresos alcanzan al capex | Los ingresos de IA siguen creciendo a ritmos altos y los márgenes mejoran | Toda la cadena, en especial nubes y laboratorios | Pocos |
| Pausa en el capex | Los hyperscalers frenan la inversión para proteger su flujo de caja | Usuarios (los precios bajan) | Chips, memoria, energía: los múltiplos se comprimen rápido |
| Comoditización de modelos | Los modelos se parecen y compiten en precio | Aplicaciones y usuarios | Laboratorios sin ventaja de distribución |
| Cuello de botella energético | La red eléctrica limita el crecimiento | Eléctricas, nuclear, gas, equipos | Quien tenga GPU sin energía para encenderlas |
Radar del inversor: seguir los acuerdos para encontrar a los beneficiarios
Los acuerdos de cómputo ya se firman en gigavatios, y cada gigavatio pone en marcha una cadena de proveedores. Los grandes nombres reaccionan primero porque aparecen en el anuncio; las empresas más pequeñas que venden los componentes, la energía o la obra lo hacen después, cuando el pedido llega a sus resultados. Ese desfase es la oportunidad, tanto para invertir como para hacer trading.
Los grandes acuerdos recientes
| Fecha | Acuerdo | Tamaño | Beneficiario directo |
|---|---|---|---|
| Abril de 2026 | Anthropic con Google y Broadcom | ~3,5 GW de capacidad TPU desde 2027 | Broadcom, Google Cloud |
| Octubre de 2025 | OpenAI con Broadcom | 10 GW de chips diseñados por OpenAI, con red Ethernet de Broadcom | Broadcom |
| Octubre de 2025 | OpenAI con AMD | Al menos 6 GW de GPU; OpenAI recibe derechos sobre hasta ~10 % de AMD | AMD |
| Septiembre de 2025 | OpenAI con NVIDIA | Al menos 10 GW; NVIDIA invertirá hasta 100.000 M$ en OpenAI | NVIDIA |
| 2025 | Stargate (OpenAI, Oracle, SoftBank) | Expansión de centros de datos en EE. UU. | Oracle |
Fuentes: Verdict (se abre en una pestaña nueva), TrendForce (se abre en una pestaña nueva), TechCrunch (se abre en una pestaña nueva). El de Anthropic se conoció por una presentación de Broadcom ante la SEC: los registros oficiales (8-K, 10-Q) suelen adelantarse a la prensa.
Ojo con la circularidad: NVIDIA invierte en OpenAI y tiene participación en CoreWeave, que a su vez tiene contratos con OpenAI; AMD da a OpenAI derechos sobre sus propias acciones. Parte de la demanda está financiada por los propios proveedores (es el riesgo de los acuerdos circulares).
Del acuerdo a los proveedores pequeños
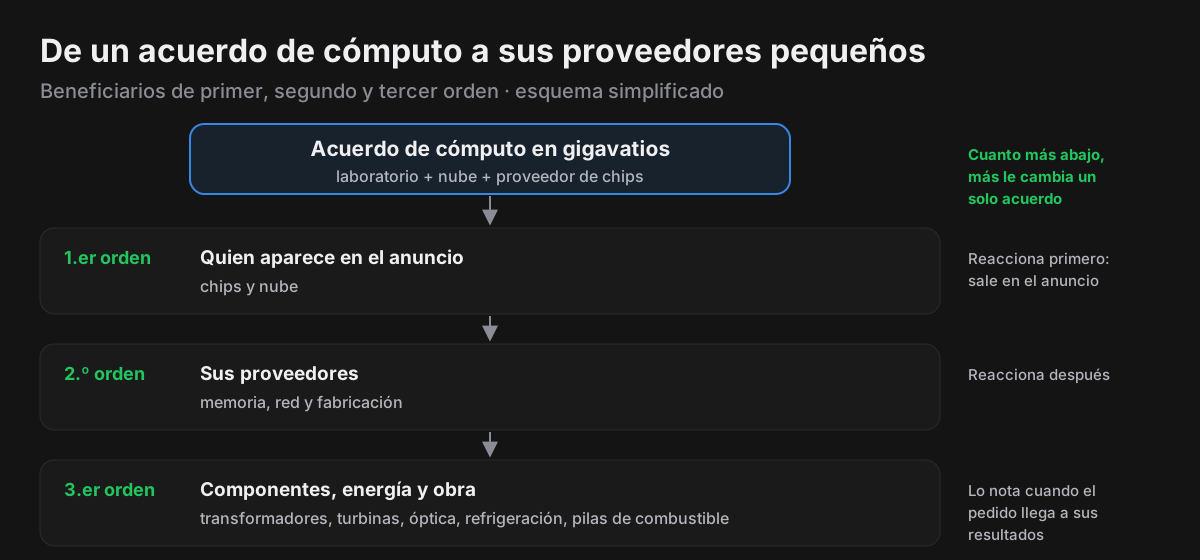
La idea, muy en la línea de Philip Fisher y Peter Lynch: cuanto más abajo en la cadena, más pequeña es la empresa en relación con el gasto que le llega, y más le puede cambiar los resultados un solo acuerdo. La pregunta clave es qué porcentaje de sus ventas supone ya la IA y si el mercado lo ha descontado.
Cómo saber dónde está el foco: sigue el cuello de botella
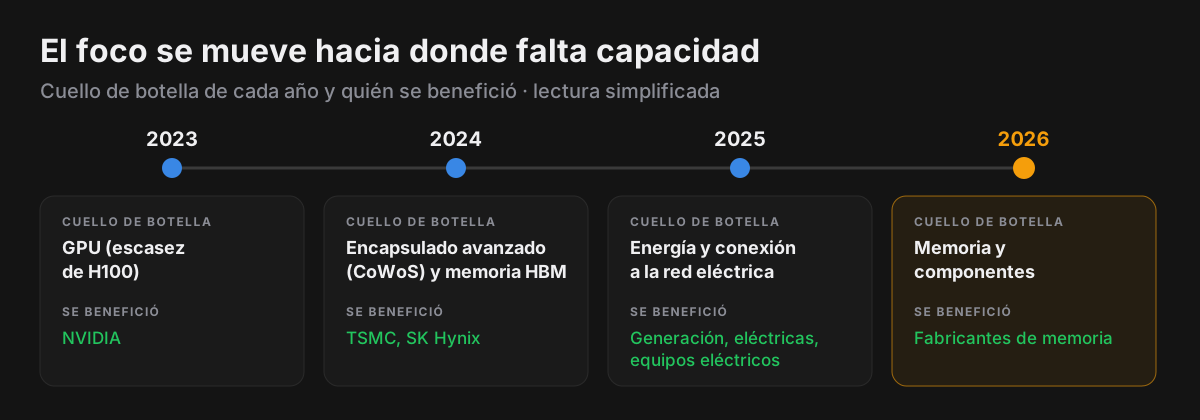
El dinero y las revalorizaciones se concentran donde falta capacidad. Ese punto ha ido cambiando (lectura simplificada):
| Periodo | Cuello de botella | Quién se benefició |
|---|---|---|
| 2026 | Memoria y componentes: NVIDIA prevé que su margen baje por el encarecimiento de la memoria, y Microsoft atribuye ~25.000 M$ de su capex a la subida de precios de componentes | Fabricantes de memoria |
| 2025 | Energía y conexión a la red eléctrica | Generación, eléctricas, equipos eléctricos |
| 2024 | Encapsulado avanzado (CoWoS de TSMC) y memoria HBM | TSMC, SK Hynix |
| 2023 | GPU (escasez de H100) | NVIDIA |
Señales para detectar el siguiente cuello de botella:
- Guías de capex de Microsoft, Alphabet, Amazon y Meta cada trimestre (finales de enero, abril, julio y octubre).
- La palabra «restricción» en las conferencias de resultados de NVIDIA, TSMC y las nubes: el componente que nombran como límite suele ser el siguiente en subir.
- Precios y plazos de entrega de memoria, transformadores eléctricos, turbinas y óptica.
- Anuncios en gigavatios y quién los suministra, leyendo los registros ante la SEC.
- Cartera de pedidos (backlog o RPO, los ingresos ya contratados pendientes de reconocer) de los proveedores: crece antes que los ingresos.
- Concentración de clientes: si un proveedor depende de uno o dos clientes, el acuerdo es a la vez oportunidad y riesgo.
La mejor fuente primaria sobre la demanda real son los resultados trimestrales de NVIDIA, Microsoft, Alphabet, Amazon, Meta, TSMC y SK Hynix.
Inversión frente a trading
| Inversión | Trading | |
|---|---|---|
| Qué buscas | Proveedores de 2.º y 3.er orden donde la IA empieza a mover los resultados y aún no está en el precio | Reacciones a anuncios de acuerdos, resultados y guías |
| Señal de entrada | Cartera de pedidos creciendo, márgenes al alza, nuevo cuello de botella | Hueco (gap) con volumen relativo muy alto el día del anuncio, y movimientos «por simpatía» en proveedores |
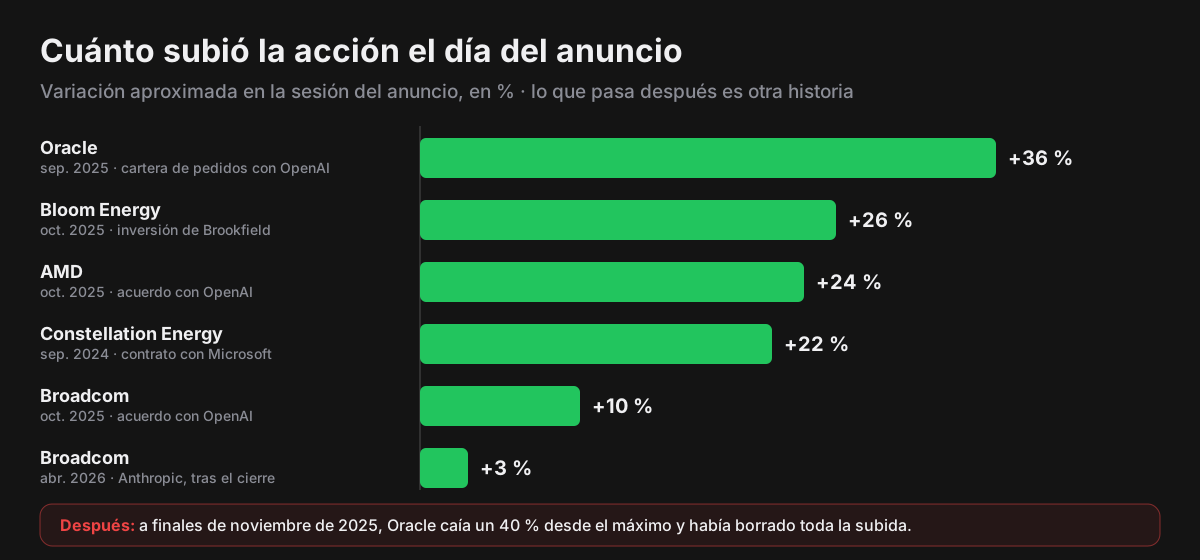
| Ejemplos | — | Oracle subió en torno a un 36 % en una sesión en septiembre de 2025 al revelar su cartera de pedidos; AMD, en torno a un 24 % el día del acuerdo con OpenAI |
| Riesgo principal | Que la pausa del capex llegue antes de que crezcan sus ventas | «Vender la noticia»: el primer día descuenta mucho |
¿Llegas tarde? En el primer orden, buena parte ya está en el precio. El valor suele estar en el siguiente cuello de botella que el mercado aún no reconoce, y en las caídas fuertes del sector, cuando el miedo a una pausa del capex castiga por igual a quien tiene pedidos firmados y a quien no.
Casos reales: qué pasó cuando se firmaron los acuerdos
Caso 1. Oracle y OpenAI (septiembre de 2025): de +36 % a −40 %
- Qué pasó: en sus resultados del 9 de septiembre de 2025, Oracle reveló una cartera de pedidos (RPO) de 455.000 M$, frente a 138.000 M$ tres meses antes (+359 % interanual). La pieza principal: un contrato de OpenAI de 300.000 M$ a cinco años desde 2027.
- Por qué Oracle: construye y alquila centros de datos de escala de gigavatio; es el socio de nube de Stargate.
- Reacción: +36 % en una sesión, la mayor subida desde 1992, sumando unos 244.000 M$ de capitalización (Seeking Alpha (se abre en una pestaña nueva)).
- Después: para financiar la obra emitió 18.000 M$ en bonos y su deuda superó los 100.000 M$; el coste de asegurar su deuda (los CDS a 5 años, un seguro contra el impago) llegó a máximos desde 2008. A finales de noviembre la acción caía un 40 % desde el máximo y había borrado toda la subida (Schwab Network (se abre en una pestaña nueva); Nasdaq (se abre en una pestaña nueva)).
- Lección: una cartera de pedidos enorme, concentrada en un solo cliente y financiada con deuda, es oportunidad de trading el día del anuncio y riesgo para quien la mantiene.
Caso 2. AMD y OpenAI (6 de octubre de 2025): un acuerdo con letra pequeña
- Qué pasó: AMD suministrará a OpenAI al menos 6 GW de GPU; el primer gigavatio, con el chip MI450, debe entrar en servicio en la segunda mitad de 2026. AMD habló de decenas de miles de millones de ingresos anuales.
- La letra pequeña: AMD da a OpenAI derechos para comprar hasta 160 millones de acciones (~10 %) a 1 céntimo cada una, a medida que se cumplan hitos de despliegue.
- Reacción: venía de cerrar a 164,67 $ (267.000 M$ de capitalización); llegó a subir más de un 30 % antes de la apertura y cerró en torno a un +24 % (Reuters vía Khaleej Times (se abre en una pestaña nueva); Sharecast (se abre en una pestaña nueva)).
- Qué vigilar ahora (octubre de 2026): si el primer gigavatio se despliega a tiempo este semestre; es el hito que confirma o no la tesis.
- Lección: mide la dilución, no solo el titular.
Caso 3. Broadcom: OpenAI (octubre de 2025) y Anthropic (abril de 2026)
- Por qué Broadcom: diseña chips a medida (fabrica las TPU de Google) y vende la red Ethernet que conecta los centros de datos.
- Primer acuerdo: 10 GW de aceleradores diseñados por OpenAI. Subió alrededor de un 10 % y sumó más de 150.000 M$ de capitalización en el día (Bloomberg (se abre en una pestaña nueva)).
- Segundo acuerdo: ~3,5 GW de capacidad TPU para Anthropic desde 2027, conocido por un registro ante la SEC. Solo +3 % tras el cierre (Verdict (se abre en una pestaña nueva)).
- Lección: cuando el mercado ya sabe que una empresa es la ganadora, cada nuevo acuerdo mueve menos la acción.
Caso 4. Constellation Energy y Microsoft (20 de septiembre de 2024): la energía entra en juego
- Qué pasó: contrato de compra de electricidad a 20 años. Constellation invertirá 1.600 M$ en reabrir la unidad 1 de Three Mile Island (837 MW) para 2028 y venderá toda su producción a Microsoft.
- Precio: Jefferies estimó que Microsoft pagará unos 110–115 $ por MWh, una prima clara sobre el mercado.
- Reacción: +22 %, la mayor subida de su historia, hasta máximos; Vistra subió también «por simpatía» (Bloomberg vía EMSNow (se abre en una pestaña nueva); Business Standard (se abre en una pestaña nueva)).
- Lección: fue la señal de que el cuello de botella pasaba a la energía. Quien lo vio pudo buscar otros generadores con capacidad disponible.
Caso 5. Bloom Energy (2025): el proveedor pequeño de tercer orden
- Por qué Bloom: fabrica pilas de combustible que generan electricidad en el propio centro de datos, sin esperar a la conexión a la red. Puso en marcha el primer centro de datos de Oracle en 90 días.
- El acuerdo: el 13 de octubre de 2025, Brookfield anunció que invertirá hasta 5.000 M$ en sus equipos (potencialmente ~1,5 GW).
- Reacción: +26 % ese día, +56 % en octubre y más de un 500 % en el año (TIKR (se abre en una pestaña nueva); Motley Fool (se abre en una pestaña nueva)).
- Capacidad: ingresos de 519 M$ en el tercer trimestre de 2025 (+57 %) y objetivo de fabricar 2 GW al año en 2026. Un solo acuerdo de 5.000 M$ equivale a varios años de ventas: por eso se mueve tanto.
- Lección: es el tipo de proveedor pequeño de tercer orden del que hablábamos. El potencial es mayor, pero también la caída si se frena la construcción de centros de datos.
Plantilla para analizar el próximo acuerdo
| Pregunta | Dónde mirarlo |
|---|---|
| ¿Cuántos GW o dólares y en qué plazo? | Nota de prensa y registro 8-K ante la SEC |
| ¿Qué % de sus ventas actuales supone? | Últimos resultados trimestrales |
| ¿Tiene capacidad para entregarlo? | Guía de producción, capex propio, plazos de entrega |
| ¿Quién paga y cómo se financia? | Deuda del cliente y del proveedor; dilución o derechos sobre acciones |
| ¿Depende de un solo cliente? | Concentración de clientes en el informe anual (10-K) |
| ¿Quién está debajo en la cadena? | Proveedores citados en sus resultados |
Si operas estas noticias, mídelo en tu diario
La columna de trading de la tabla anterior tiene una trampa: el día del anuncio todo parece obvio, y solo tu registro te dice si de verdad ganas dinero con estos movimientos o si «vender la noticia» te pilla una y otra vez. Si operas acuerdos, resultados o movimientos por simpatía del sector de la IA, apúntalos con el catalizador que los mueve.
- Catalizador en cada operación. En el Trade Log de The Trader Journal clasificas cada operación por tipo de catalizador: «Partnership / Deal» o «Contract Win» para un acuerdo, «Earnings» o «Guidance / Profit Warning» para unos resultados, y «Sector / Industry Theme» o «Competitor Headline» para los movimientos por simpatía.
- Persistencia del movimiento. Marca si fue «Relámpago» (menos de 15 minutos), «Onda» (sostenido durante la sesión) o «Tectónico» (varias sesiones). Es la forma de saber si el primer día lo descuenta todo en tus operaciones.
- Qué te funciona. En Stats → Resumen, el desglose por categorías compara tu P&L total, la expectativa y el % de aciertos por catalizador y por persistencia.
Entrar tarde en un hueco de apertura es el escenario típico del FOMO en el trading, y mantener la posición de un día para otro te expone al riesgo nocturno del swing trading, el hueco que tu stop no ve. En días de anuncios, además, el precio al que te ejecutan puede alejarse mucho del previsto: mídelo con el slippage.
Preguntas frecuentes sobre IA y finanzas
¿Qué es un token en inteligencia artificial?
Es la unidad mínima de texto con la que trabaja un modelo de lenguaje: una palabra, un trozo de palabra o un signo. Cada token tiene un número, y los proveedores cobran por millón de tokens de entrada y de salida.
¿Cuántos tokens tiene una palabra en español?
Depende del tokenizador de cada modelo. Como referencia, en inglés 1 token son unos 4 caracteres o 0,75 palabras, y en español el mismo texto suele necesitar 1,2–1,5 veces más tokens. Para saberlo con exactitud, pega tu texto en el tokenizador del proveedor que uses.
¿Cuánto cuesta entrenar un modelo de IA?
Desde unos cientos de miles de dólares en modelos pequeños hasta cientos de millones en los modelos frontera, con costes que crecen unas 2,4 veces al año. Y la ejecución final es una parte pequeña: en 2024, solo ~10 % del cómputo de I+D de OpenAI fue a los modelos publicados.
¿Qué diferencia hay entre RLHF, DPO y Constitutional AI?
Las tres sirven para alinear el modelo. El RLHF usa evaluadores humanos y un modelo de recompensa; DPO elimina ese modelo intermedio y entrena directamente con pares de respuestas preferidas y rechazadas; la Constitutional AI usa una IA «juez» que revisa las respuestas contra una constitución escrita por personas.
¿Por qué la IA se inventa datos?
Porque en el pre-entrenamiento no ve etiquetas de verdadero o falso y no puede deducir datos sueltos que aparecieron pocas veces, y porque los exámenes con los que se miden los modelos premian contestar antes que decir «no lo sé». Por eso conviene comprobar siempre la fuente de cualquier cifra.
¿Es rentable un usuario de pago de ChatGPT o Claude?
Depende de lo que use él y de cuántos usuarios gratuitos subvencione. En el ejemplo de este artículo (20 $ de cuota, 10 $ de uso propio, 4 % de conversión y 0,30 $ por gratuito) deja 2,80 $ de margen bruto de inferencia al mes, y basta con que el gratuito cueste 0,60 $ para que el margen sea negativo.
¿Qué empresas ganan dinero con la inteligencia artificial?
A octubre de 2026, el margen se concentra en la parte baja de la cadena: fabricación de chips, chips (NVIDIA declaró un margen bruto del 75 %), memoria HBM y energía. Los laboratorios crecen muy rápido, pero gastan de 2 a 3 veces lo que ingresan, y las nubes todavía tienen que demostrar el retorno de su inversión.
¿Qué significa ingreso anualizado (run rate)?
Es el ingreso del último mes multiplicado por 12. No es lo mismo que el ingreso anual: en una empresa que crece rápido se parece bastante, pero en una que se frena puede sobrevalorar mucho lo que ingresará de verdad.
¿Qué son los registros 8-K, 10-Q y 10-K?
Son documentos que las empresas cotizadas en EE. UU. presentan ante la SEC. El 8-K es el informe de hechos relevantes, que en general se presenta en los cuatro días hábiles siguientes al hecho (investor.gov, Form 8-K (se abre en una pestaña nueva)); el 10-Q es el informe trimestral, con estados financieros sin auditar (investor.gov, Form 10-Q (se abre en una pestaña nueva)), y el 10-K, el informe anual. Los acuerdos de cómputo suelen aparecer antes en estos registros que en la prensa.
¿Es buen momento para invertir en inteligencia artificial?
Esta guía no puede responderte eso: no es asesoramiento de inversión y no recomienda ninguna empresa. Lo que sí te da es un método para formarte tu propia opinión: saber en qué eslabón de la cadena está cada empresa, si paga o cobra por cómputo, cómo cuenta sus ingresos, cuánto depende de un solo cliente y dónde está el cuello de botella de cada momento.
Fuentes y recursos
- Artificial Analysis: precios por millón de tokens, velocidad y latencia de los proveedores de API (se abre en una pestaña nueva)
- SemiAnalysis: análisis económico de semiconductores y de márgenes de inferencia (se abre en una pestaña nueva)
- Sequoia Capital: AI's $600B Question (David Cahn, junio de 2024) (se abre en una pestaña nueva)
- Epoch AI: datos sobre entrenamiento, cómputo, costes y benchmarks (se abre en una pestaña nueva)
- Epoch AI Benchmarks (se abre en una pestaña nueva)
- Anthropic: precios de la API (se abre en una pestaña nueva)Precios, tokenizador y contexto de 1M. Consultado el 06/10/2026.
- OpenAI: precios de la API (se abre en una pestaña nueva)
- Google: precios de la API de Gemini (se abre en una pestaña nueva)
- Google Cloud: precios de IA generativa en Vertex AI (se abre en una pestaña nueva)
- OpenAI: tokenizador (se abre en una pestaña nueva)
- TensorFlow Embedding Projector (se abre en una pestaña nueva)
- Petrov et al. (2023). Language Model Tokenizers Introduce Unfairness Between Languages (NeurIPS 2023) (se abre en una pestaña nueva)
- Epoch AI: How much does it cost to train frontier AI models? (se abre en una pestaña nueva)
- Epoch AI: In both China and the US, compute makes up more than 50% of the cost of running an AI company (se abre en una pestaña nueva)
- Dror Poleg: coste de los entrenamientos frontera (datos de Epoch AI) (se abre en una pestaña nueva)
- Epoch AI: Final training runs account for a minority of R&D compute spending (se abre en una pestaña nueva)
- Epoch AI: Most of OpenAI's 2024 compute went to experiments (se abre en una pestaña nueva)
- Epoch AI: AI Chip Users explorer (se abre en una pestaña nueva)
- Anthropic: Claude's new constitution (22/01/2026) (se abre en una pestaña nueva)
- Anthropic: constitución de Claude (texto completo) (se abre en una pestaña nueva)
- Bloomberg Law: Bartz v. Anthropic, aprobación final del acuerdo de 1.500 M$ (se abre en una pestaña nueva)
- OpenAI: Why language models hallucinate (septiembre de 2025) (se abre en una pestaña nueva)
- The Decoder: márgenes y costes de inferencia de OpenAI (se abre en una pestaña nueva)
- Techeconomy: ingresos anualizados de Anthropic (se abre en una pestaña nueva)
- TypeSafe AI: Introducing System One Models and Jev (se abre en una pestaña nueva)
- TypeSafe AI: documentación de Score (se abre en una pestaña nueva)
- SiliconANGLE: AMI Labs de Yann LeCun levanta 1.030 M$ (se abre en una pestaña nueva)
- IEA: Energy and AI (se abre en una pestaña nueva)
- NVIDIA: resultados del segundo trimestre del año fiscal 2027 (nota de prensa, vía Barchart) (se abre en una pestaña nueva)
- NVIDIA: relación con inversores (se abre en una pestaña nueva)
- Yahoo Finance: capex de los hyperscalers en 2026 (se abre en una pestaña nueva)
- Om Malik: What I learned about hyperscalers' AI spend (se abre en una pestaña nueva)
- Anthropic: acceso a Claude Fable y Mythos (se abre en una pestaña nueva)
- investor.gov (SEC): Form 8-K (se abre en una pestaña nueva)
- investor.gov (SEC): Form 10-Q (se abre en una pestaña nueva)